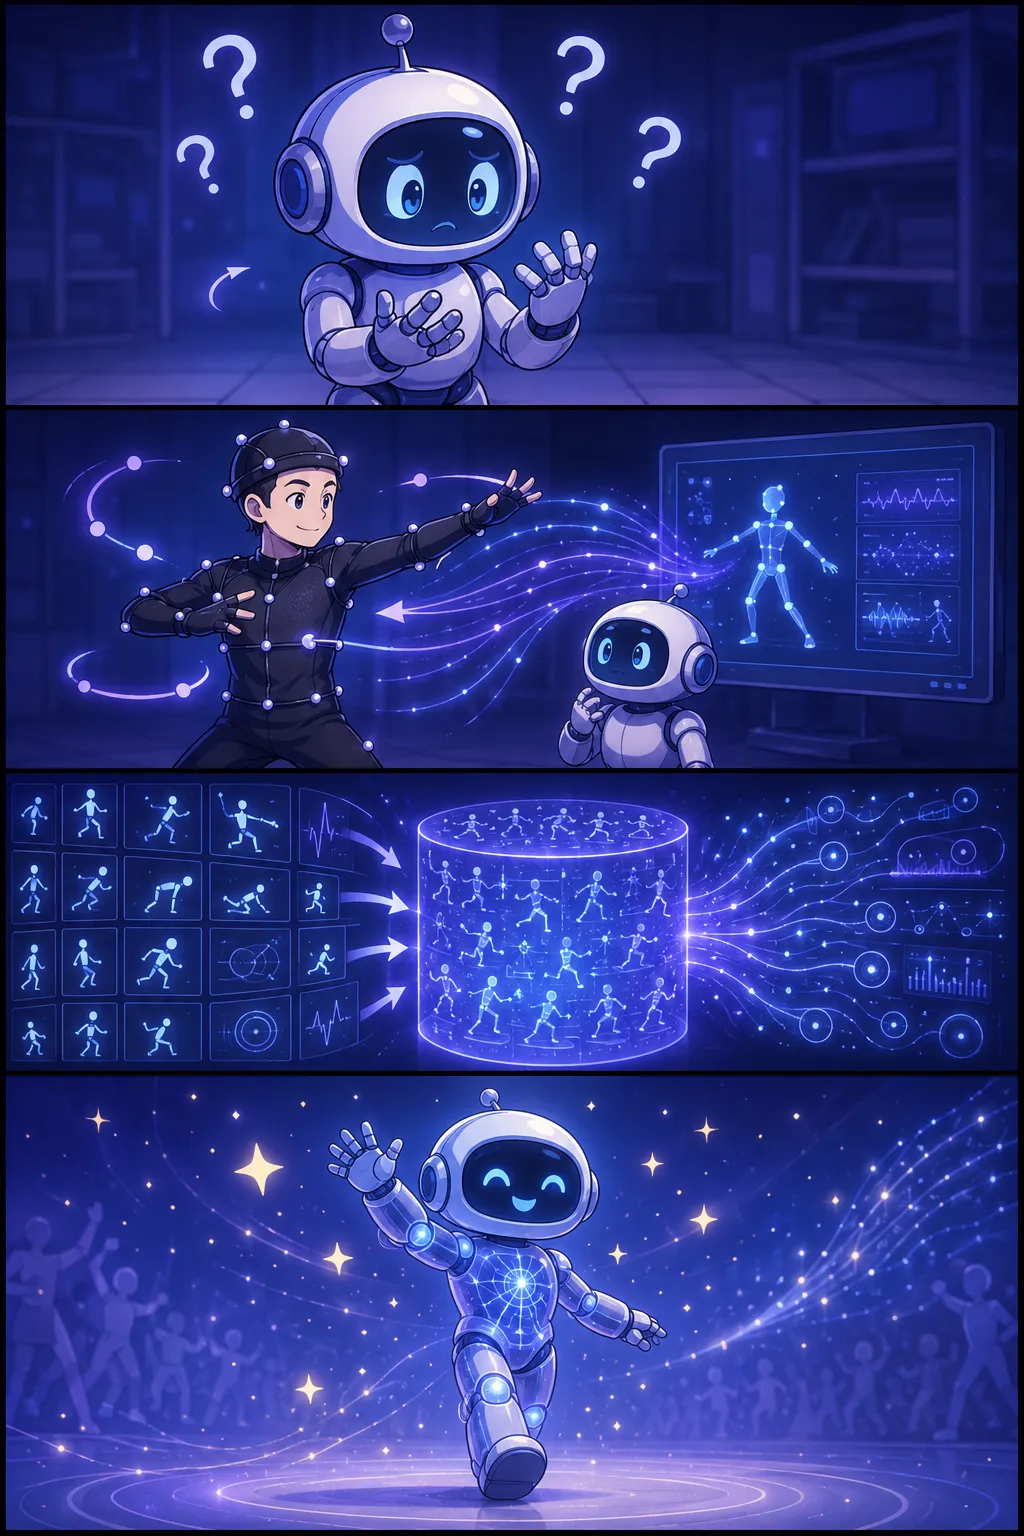
- 1로봇, 넌 어떻게 움직이는 거야?
- 2사람이 직접 시범을 보여줘요
- 3수천 번의 동작이 데이터가 돼요
- 4로봇이 스스로 움직이기 시작!
정의와 배경
로봇 학습 데이터란 로봇이 물리 환경에서 특정 동작·작업을 자율적으로 수행할 수 있도록 AI 모델을 훈련시키는 데 사용하는 데이터셋을 의미한다. 전통적인 산업용 로봇은 사람이 명시적으로 프로그래밍한 규칙에 따라 움직였지만, 피지컬 AI 시대에는 데이터 기반 학습을 통해 로봇 스스로 다양한 상황에 적응하는 방향으로 패러다임이 전환되고 있다. 이에 따라 양질의 학습 데이터 확보는 로봇 성능을 좌우하는 핵심 경쟁 요소로 부상하였다.
구성 요소와 종류
로봇 학습 데이터는 크게 세 가지 유형으로 나뉜다. 첫째, 카메라·라이다·IMU 등 각종 센서가 수집한 환경 인식 데이터로, 로봇이 주변 공간과 사물을 이해하는 데 활용된다. 둘째, 인간이 직접 로봇 팔을 조작하거나 착용형 장치로 동작을 시연한 '시연(Demonstration) 데이터'로, 모방 학습(Imitation Learning)의 핵심 원료가 된다. 셋째, 시뮬레이터(월드모델) 환경에서 대규모로 생성한 합성 데이터로, 현실에서 수집하기 어렵거나 위험한 상황을 보완한다.
최근에는 이 세 유형을 결합하여 실제 환경과 가상 환경을 오가며 데이터를 축적하는 'Sim-to-Real' 접근법이 널리 사용된다.
왜 중요한가
로봇 학습 데이터의 규모와 다양성은 로봇이 얼마나 범용적이고 견고하게 동작하는지를 직접 결정한다. 데이터가 부족하거나 편향되면 로봇은 학습하지 않은 상황에서 오류를 일으키며, 특히 휴머노이드처럼 복잡한 관절 구조를 가진 로봇일수록 방대한 데이터가 요구된다. 피지컬 AI 메가프로젝트에서 로봇 학습 데이터 인프라 구축이 핵심 과제로 설정되는 이유도 이 때문이다. 나아가 제조AI 파운데이션 모델이나 풀스택 AI팩토리와 결합할 경우, 축적된 데이터는 여러 로봇 플랫폼에 재사용 가능한 범용 자산이 되어 산업 전반의 자동화 수준을 높이는 공공재적 성격을 갖는다.
정책·실무적 시사점
공공 및 산업 현장에서 로봇 학습 데이터를 확보하려면 데이터 수집 표준화, 개인정보 보호, 데이터 공유 체계 마련이 선행되어야 한다. 국내외 주요국은 공개 데이터셋 구축과 시뮬레이션 플랫폼 지원을 통해 기업과 연구기관이 학습 데이터를 효율적으로 생성·공유할 수 있는 생태계 조성에 나서고 있다. 실무 담당자는 데이터의 양뿐만 아니라 작업 다양성, 레이블 품질, 실환경 대표성 등 질적 요소를 함께 검토하는 것이 중요하다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.