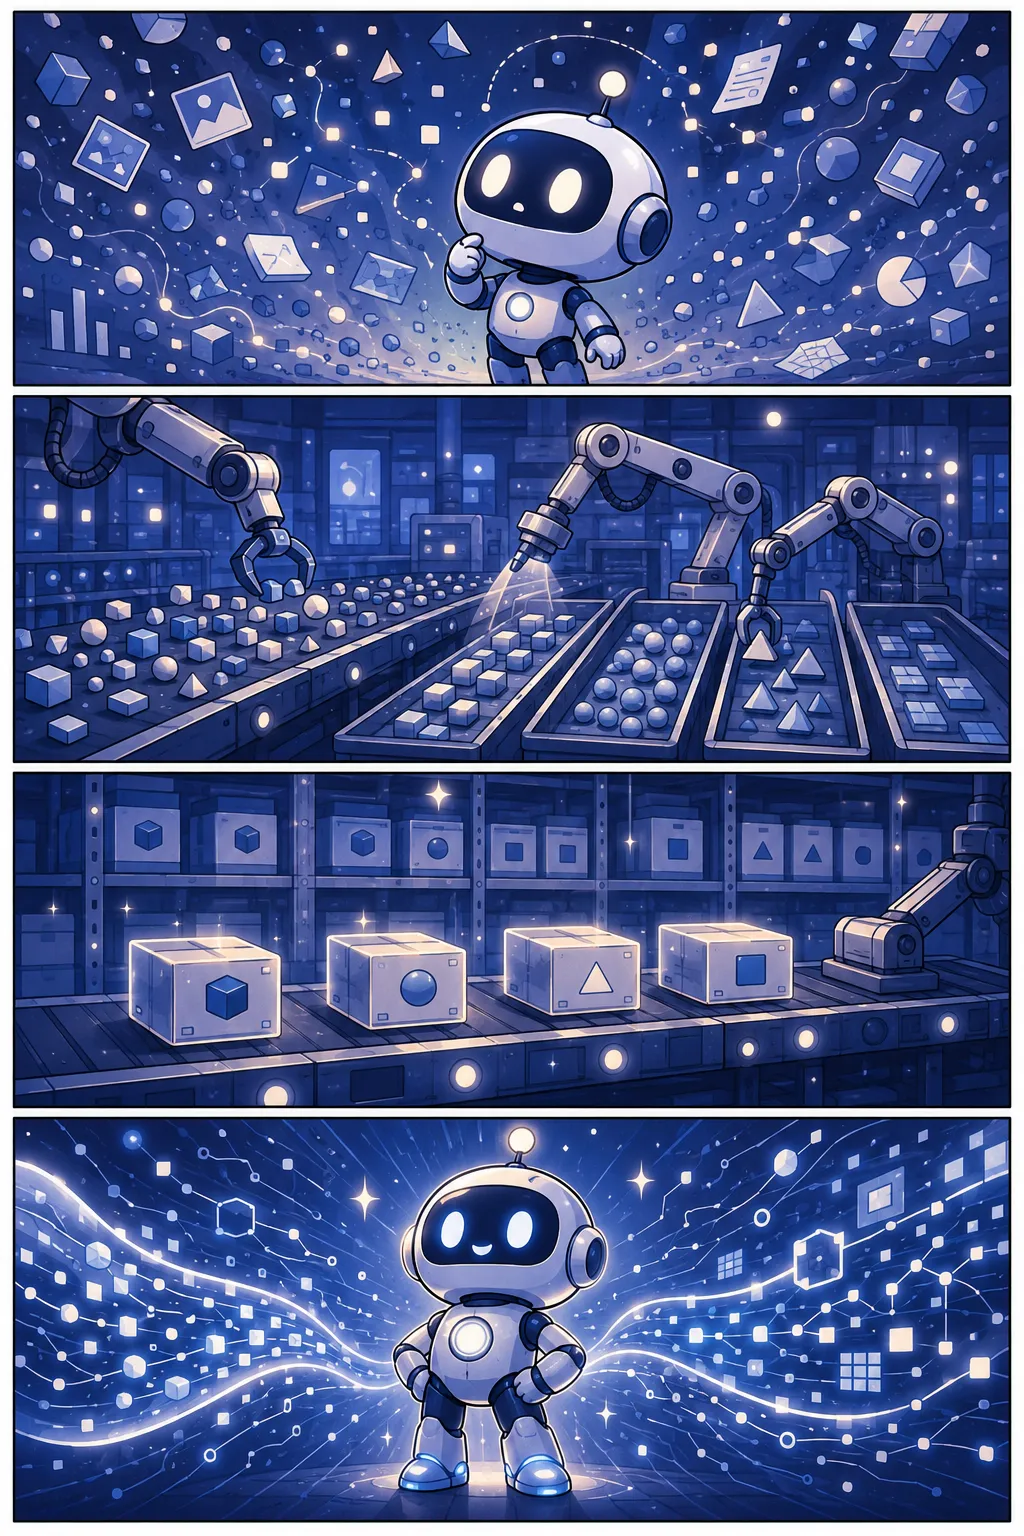
- 1로봇, 세상을 배우고 싶어요!
- 2공장처럼 데이터를 모으고 다듬고
- 3깔끔하게 정제된 데이터 완성!
- 4로봇이 똑똑하게 성장했어요 🤖✨
정의와 배경
데이터 라이브러리는 피지컬 AI 메가프로젝트 맥락에서 '데이터팩토리'의 파생 개념으로 등장한 용어다. 데이터팩토리가 로봇·센서·시뮬레이션 환경을 통해 피지컬 AI 훈련용 데이터를 생산하는 '제조 공정'에 해당한다면, 데이터 라이브러리는 그 결과물을 보관·관리·유통하는 '저장·공급 체계'에 해당한다.
소프트웨어 분야에서 라이브러리가 재사용 가능한 코드 모음을 의미하듯, 피지컬 AI 맥락의 데이터 라이브러리는 여러 로봇 개발 주체가 반복 수집하는 비효율을 줄이고 표준화된 데이터를 공동으로 활용하기 위한 인프라다. 국내외 피지컬 AI 경쟁이 심화되면서 양질의 학습 데이터 확보가 기술 격차를 결정짓는 핵심 요소로 부각됨에 따라 그 중요성이 높아지고 있다.
구성 요소와 작동 방식
데이터 라이브러리는 크게 데이터 수집·입력 계층, 정제·표준화 계층, 검색·제공 계층으로 구성된다. 수집 단계에서는 로봇 동작 궤적, 카메라·라이다·촉각 센서 데이터, 시뮬레이터(월드모델) 생성 합성 데이터 등이 유입되며, 정제 단계에서는 노이즈 제거·레이블링·포맷 통일 작업이 이루어진다.
표준화된 데이터는 작업 유형(파지, 이동, 조립 등), 환경 조건, 로봇 플랫폼 등 다양한 메타데이터로 분류·색인되어, 개발자가 필요한 데이터를 검색하고 즉시 학습에 활용할 수 있도록 제공된다. 휴머노이드나 협동로봇용 파운데이션 모델 훈련 시, 라이브러리에 축적된 대규모 다양성 데이터가 모델의 일반화 성능을 높이는 핵심 자원이 된다.
피지컬 AI 메가프로젝트 내 역할
피지컬 AI 메가프로젝트는 풀스택 AI팩토리·제조AI 파운데이션 모델·휴머노이드 등 여러 축이 상호 연결된 생태계를 지향한다. 데이터 라이브러리는 이 생태계에서 '공용 원자재 창고'와 같은 역할을 수행하며, 개별 기업이나 연구기관이 중복 투자 없이 고품질 데이터를 공유함으로써 전체 생태계의 개발 속도를 높인다.
특히 국내 중소 로봇 기업이나 스타트업은 대규모 데이터 수집 인프라를 독자적으로 구축하기 어렵기 때문에, 정부 주도 메가프로젝트 차원에서 데이터 라이브러리를 공공재로 운영하는 방식이 논의된다. 이는 AI 에이전트와 피지컬 AI가 결합한 자율 제조 환경 실현을 위한 데이터 기반 조성 전략의 일환이다.
정책·실무적 시사점
공무원·정책 실무자 관점에서 데이터 라이브러리는 데이터 거버넌스, 지식재산권, 보안이라는 세 가지 쟁점을 수반한다. 기업이 생산한 데이터를 공유 라이브러리에 기탁하도록 유인하기 위해서는 기여도에 따른 인센티브 체계와 데이터 소유권 보호 장치가 병행되어야 한다.
또한 산업용 로봇 동작 데이터에는 공장 레이아웃·공정 정보 등 민감한 영업 비밀이 포함될 수 있으므로, 접근 권한 관리와 비식별·익명화 처리 기준을 사전에 마련하는 것이 중요하다. 데이터 라이브러리의 품질과 규모가 국내 피지컬 AI 산업 경쟁력과 직결되는 만큼, 관련 표준 수립과 국제 협력 방향도 정책 의제로 다루어질 필요가 있다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.