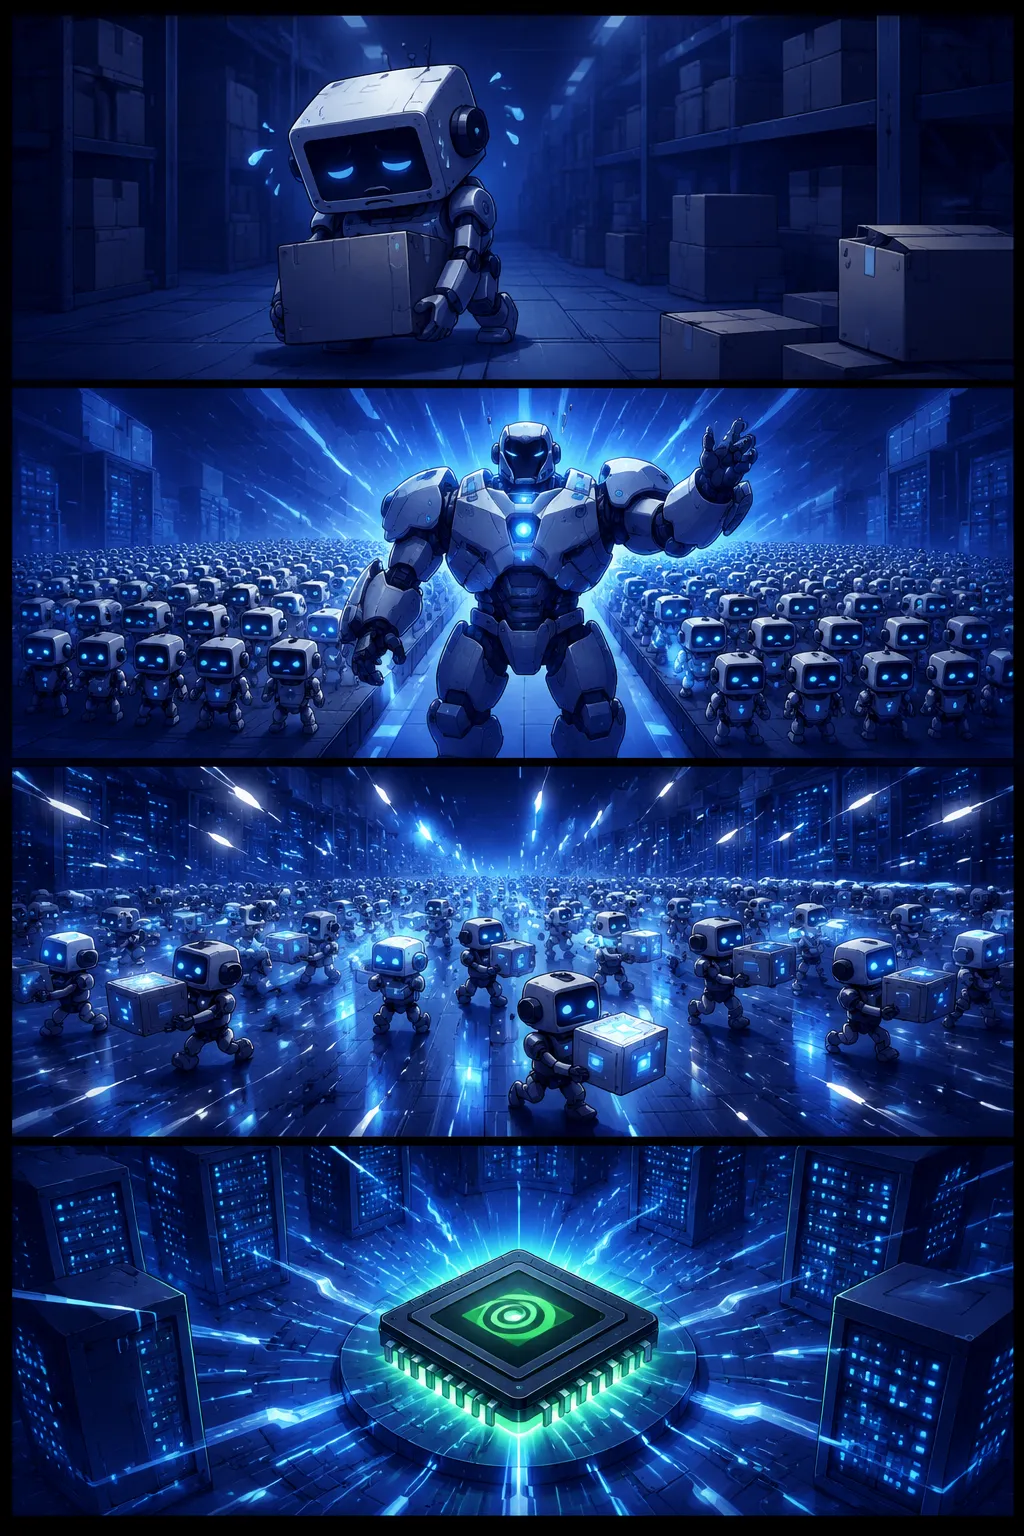
- 11컷: CPU 혼자 연산 중… 너무 느려!
- 22컷: GPU 등장! 수천 개 코어가 한꺼번에!
- 33컷: AI 학습 데이터 폭풍 처리 완료!
- 44컷: 엔비디아 GPU, 데이터센터의 심장이 되다
정의와 배경
TPU는 구글이 자사의 AI 서비스 수요를 감당하기 위해 내부적으로 개발한 맞춤형 AI 가속 칩으로, GPU 기반 범용 연산과 구별되는 특수목적 프로세서(ASIC)에 해당한다. 딥러닝 모델은 대규모 행렬 연산(텐서 연산)을 반복 수행하는데, TPU는 이 연산 패턴에 최적화된 회로 구조를 채택하여 전력 대비 연산 성능(TOPS/W)을 극대화한다. 구글은 자사 서비스의 검색·번역·이미지 인식 등 AI 추론 부하가 급증하면서 기존 CPU·GPU만으로는 전력 및 비용 효율에 한계가 있다고 판단해 TPU를 개발하게 되었다.
작동 원리와 GPU와의 차이
TPU의 핵심 연산 유닛은 '시스톨릭 어레이(Systolic Array)'로, 수천 개의 곱셈-누산기(MAC)가 데이터를 물 흐르듯 연속 전달하며 행렬 곱셈을 병렬 처리한다. 이 구조는 메모리와 연산 유닛 간 데이터 이동을 최소화해 메모리 대역폭 병목을 줄인다는 점에서 GPU의 범용 CUDA 코어 방식과 차별화된다. GPU는 그래픽 렌더링부터 과학 시뮬레이션까지 다양한 병렬 워크로드를 처리할 수 있는 반면, TPU는 부동소수점 연산 유연성보다 정수·저정밀도(BF16, INT8) 텐서 연산 처리량을 우선하는 설계 철학을 따른다. 이로 인해 범용 연산이나 비정형 알고리즘에는 적합하지 않지만, LLM·파운데이션 모델 학습 및 추론처럼 반복적이고 구조화된 텐서 연산에서는 높은 효율을 발휘한다.
생태계·경쟁 구도와 AIDC 맥락
AI 가속 칩 시장은 엔비디아 GPU가 압도적 점유율을 유지하고 있으나, 구글 TPU 외에도 아마존 Trainium·Inferentia, 메타의 MTIA, 국내외 팹리스 스타트업들이 자체 AI 칩을 개발하며 경쟁이 심화되고 있다. TPU는 구글 클라우드(GCP)의 핵심 인프라로 통합되어 있어, 외부 기업·연구기관도 클라우드를 통해 TPU 자원에 접근할 수 있다. 대한민국의 AIDC 메가프로젝트(8.4GW 규모) 등 대규모 AI 데이터센터 구축 맥락에서는 GPU뿐 아니라 TPU와 같은 특수목적 AI 가속 칩의 도입·조달 전략이 인프라 경쟁력과 비용 효율을 좌우하는 주요 변수로 부상하고 있다.
정책·실무적 시사점
공공·산업 정책 입안자 입장에서 TPU는 AI 반도체 공급망 다변화의 관점에서 중요하다. 엔비디아 GPU 의존도를 낮추고 싶은 조직이나 국가는 TPU를 비롯한 대안적 AI 가속 칩을 클라우드 또는 온프레미스 형태로 활용하는 방안을 검토할 수 있다. 다만 TPU는 소프트웨어 생태계(주로 구글의 JAX·TensorFlow 프레임워크 중심)가 GPU 대비 협소하여 모델 이식성과 개발자 확보에 추가 비용이 발생할 수 있으므로, 도입 시 기술 스택 호환성을 면밀히 검토해야 한다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.