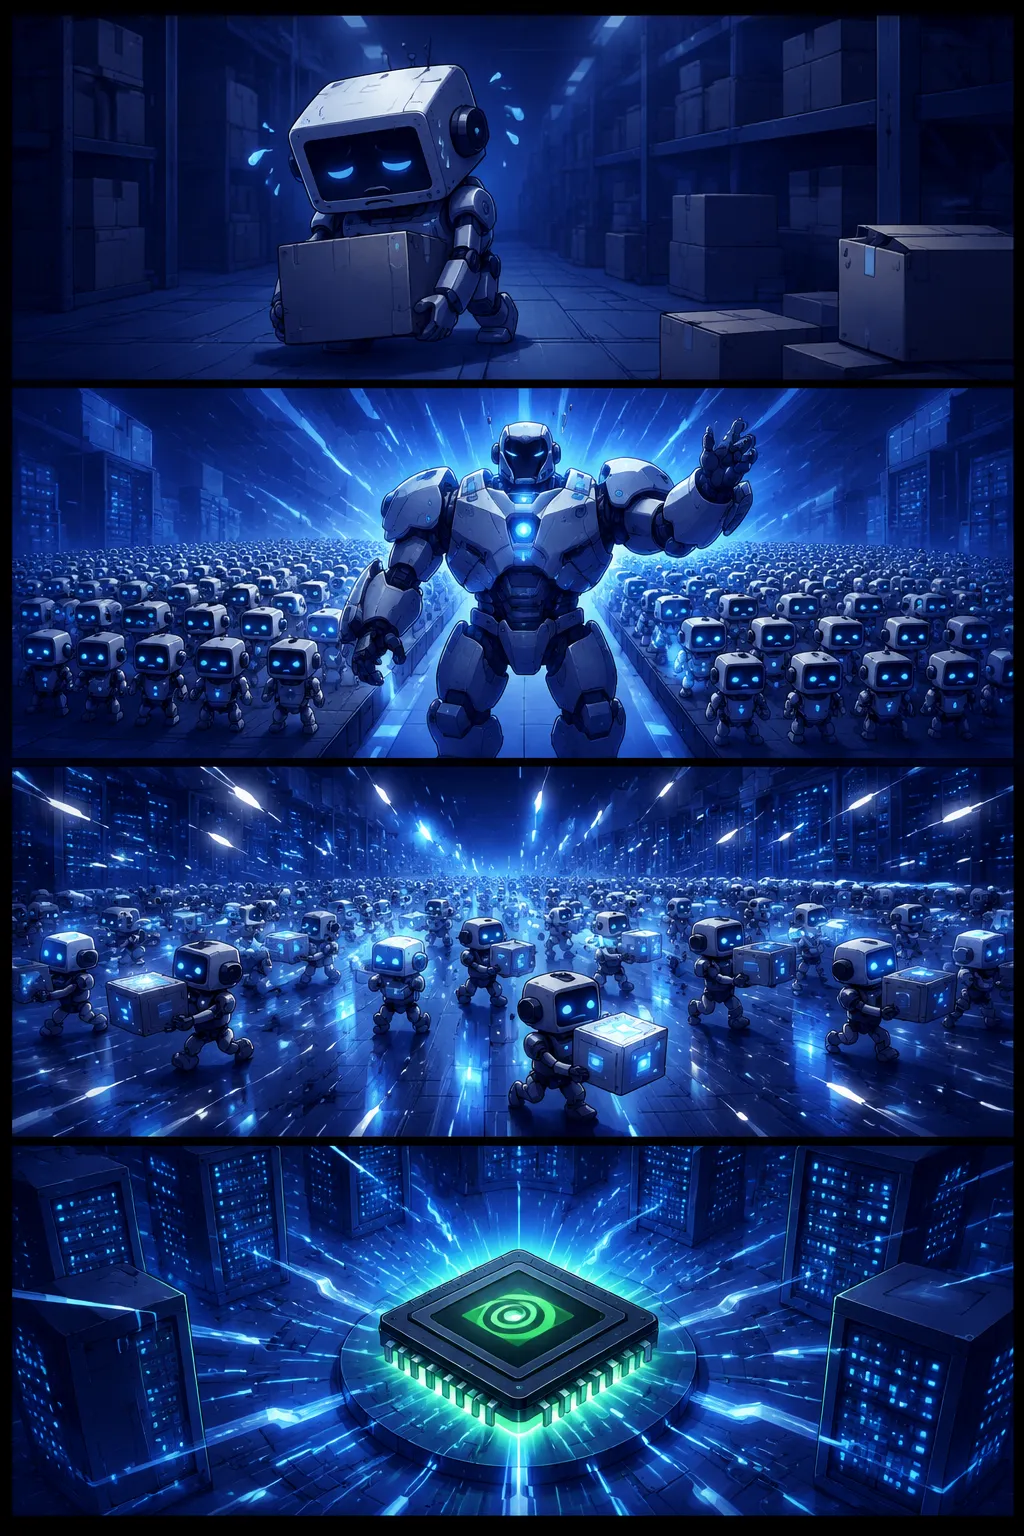
- 11컷: CPU 혼자 연산 중… 너무 느려!
- 22컷: GPU 등장! 수천 개 코어가 한꺼번에!
- 33컷: AI 학습 데이터 폭풍 처리 완료!
- 44컷: 엔비디아 GPU, 데이터센터의 심장이 되다
정의와 배경
GPU 클러스터란 개별 GPU 서버 수십~수만 대를 초고속 인터커넥트(예: InfiniBand, NVLink 등)로 연결해 단일 연산 풀처럼 운용하는 분산 컴퓨팅 구성을 말한다. 단일 GPU의 메모리와 연산 용량이 대규모 AI 모델을 처리하기에 부족해짐에 따라, 다수의 GPU를 묶어 모델 병렬화·데이터 병렬화를 구현하는 방식이 산업 표준으로 자리 잡았다. 특히 수십억~수천억 파라미터 규모의 LLM과 파운데이션 모델이 등장하면서 GPU 클러스터의 규모는 빠르게 확대되고 있다.
구성 원리와 주요 기술 요소
GPU 클러스터는 크게 ① 연산 노드(GPU 서버), ② 노드 간 고속 패브릭 네트워크, ③ 고성능 분산 스토리지, ④ 클러스터 오케스트레이션 소프트웨어(예: Kubernetes, Slurm 등)로 구성된다. 노드 내부에서는 NVLink 같은 GPU 간 직접 연결 기술로 메모리 대역폭을 극대화하고, 노드 간에는 InfiniBand 또는 고속 이더넷으로 수십~수백 Gbps 수준의 통신 속도를 확보한다. 학습 작업에서는 그래디언트 집계와 파라미터 동기화가 빈번히 발생하므로, 네트워크 지연이 전체 학습 효율을 좌우하는 병목 요소가 된다.
엔비디아의 H100·A100 계열 GPU가 현재 클러스터 구축의 주류를 이루며, 복수의 GPU를 단일 보드에 탑재한 HGX 모듈 형태로 공급된다.
왜 중요한가
AI 모델의 성능은 투입 컴퓨팅 자원(연산량)과 밀접하게 비례하는 스케일링 법칙(Scaling Law)이 확인되면서, GPU 클러스터의 규모 자체가 국가·기업의 AI 경쟁력을 나타내는 지표가 되었다. 생성형 AI 서비스를 상용화하려면 추론 단계에서도 대규모 GPU 클러스터를 상시 운용해야 하므로, 클러스터 구축·운영 비용은 AI 산업의 핵심 진입 장벽으로 작용한다. 이에 따라 각국 정부와 클라우드 사업자는 GPU 클러스터 확충에 막대한 투자를 집행하고 있다.
AIDC 메가프로젝트(8.4GW 규모) 맥락
대한민국 정부의 AIDC 메가프로젝트는 국내에 대규모 AI 데이터센터를 구축하고 세계적 수준의 GPU 클러스터를 확보하는 것을 핵심 목표 중 하나로 삼는다. 충분한 GPU 클러스터 용량을 국내에 확보함으로써 국내 AI 스타트업·연구기관이 해외 클라우드에 의존하지 않고 대형 모델을 학습·서비스할 수 있는 기반을 조성하는 것이 정책적 취지다. GPU 클러스터 투자는 단순 시설 인프라를 넘어 에너지·냉각·네트워크 등 연관 산업 생태계 전반에 파급 효과를 미친다는 점에서 정책 우선순위가 높다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.