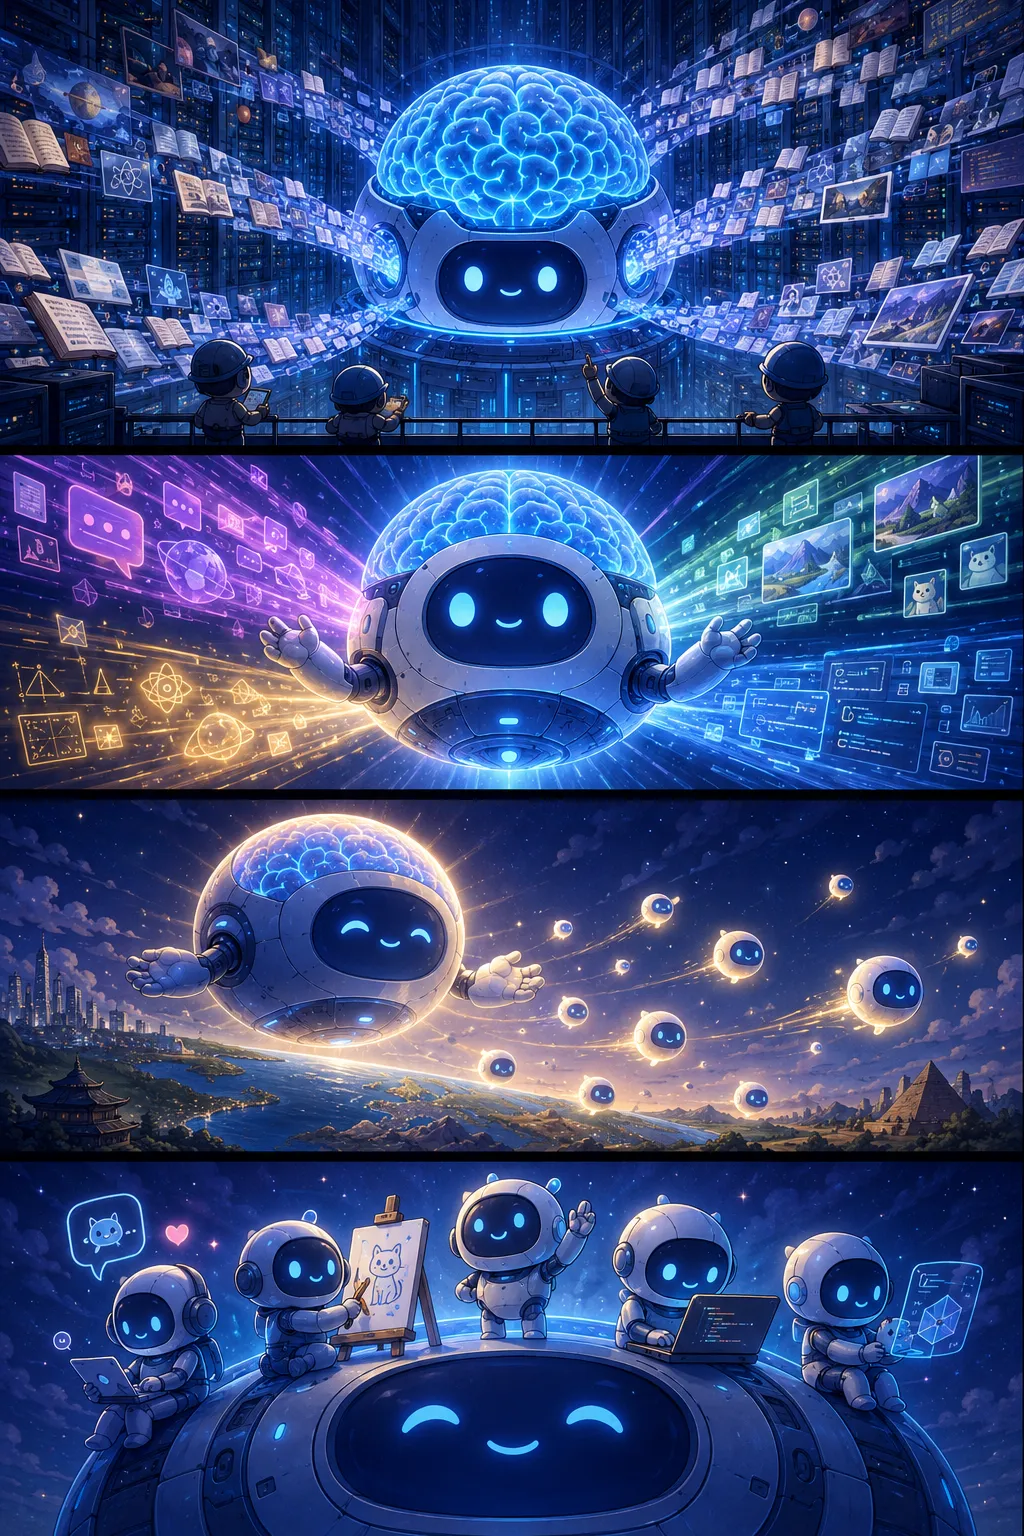
- 1🏗️ 엄청난 데이터로 훈련 중인 거대 AI...
- 2📚 언어도, 이미지도, 코드도 다 배웠어!
- 3🌱 '파운데이션'이 되어 세상에 나가다
- 4🚀 모든 AI 앱의 든든한 기초가 되었습니다
정의와 배경
사전학습이란 AI 모델이 특정 응용 서비스에 배치되기 전, 인터넷 텍스트·도서·코드 등 수천억~수조 개 토큰 규모의 비정형 데이터를 활용해 범용적인 언어 이해 및 지식 표현 능력을 체득하는 과정이다. 전통적인 머신러닝이 좁은 목적의 데이터로 모델을 처음부터 훈련하는 것과 달리, 사전학습은 '공통 기반 지식'을 먼저 구축하고 이를 다양한 하위 과제에 재활용한다는 패러다임 전환을 의미한다.
이 개념은 트랜스포머(Transformer) 아키텍처의 등장 이후 본격화되었으며, 오늘날 LLM과 파운데이션 모델의 핵심 구성 원리로 자리 잡았다.
작동 원리와 학습 방식
사전학습 단계에서 모델은 주로 '다음 토큰 예측(Next Token Prediction)' 또는 '마스크 언어 모델링(Masked Language Modeling)' 같은 자기지도학습(Self-supervised Learning) 방식으로 훈련된다. 별도의 정답 레이블 없이 데이터 자체의 내부 구조를 예측 과제로 삼기 때문에, 레이블 작업 비용 없이도 초대규모 데이터를 활용할 수 있다는 장점이 있다.
학습이 완료된 모델은 이후 목표 과제에 맞는 소규모 데이터로 미세조정(Fine-tuning)하거나, 인간 피드백 강화학습(RLHF) 등의 정렬(Alignment) 과정을 거쳐 실제 서비스에 적용된다. 즉, 사전학습은 모델의 '기초 체력'을 키우는 단계이고, 미세조정은 '전문성'을 부여하는 단계로 구분할 수 있다.
왜 중요한가 — 컴퓨팅 인프라와의 연관성
사전학습은 AI 개발 전 주기 중 가장 많은 연산 자원을 소비하는 단계로, 수백에서 수천 개의 고성능 GPU를 수주~수개월간 지속 가동해야 한다. 이 때문에 AIDC(AI 데이터센터) 구축의 핵심 수요 동인이 되며, 엔비디아 GPU 수요 급증의 직접적 원인이기도 하다.
대한민국의 AIDC 메가프로젝트(8.4GW 규모)가 추진되는 배경에도 국내 산업계와 공공기관이 사전학습 단계부터 독자적 파운데이션 모델을 개발·보유할 수 있는 인프라 기반을 확보하려는 전략적 판단이 자리하고 있다. 사전학습 역량의 내재화 여부는 AI 주권 확보 및 기술 자립도와 직결되는 정책 과제로 평가된다.
정책·실무 시사점
공공 및 산업 실무자 입장에서 사전학습은 단순한 기술 개념을 넘어 '누가 모델의 기반 지식을 설계하고 통제하는가'라는 거버넌스 문제와 연결된다. 해외 빅테크가 공개하지 않은 사전학습 데이터와 모델 가중치에 대한 의존도가 높아질수록, 국내 서비스의 안전성·편향성·보안성 검증이 어려워진다.
따라서 정부의 AI 컴퓨팅 인프라 투자, 공개 데이터셋 구축, 국산 파운데이션 모델 지원 정책은 모두 사전학습 단계의 자국 역량 확보를 궁극적 목표로 한다고 볼 수 있다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.