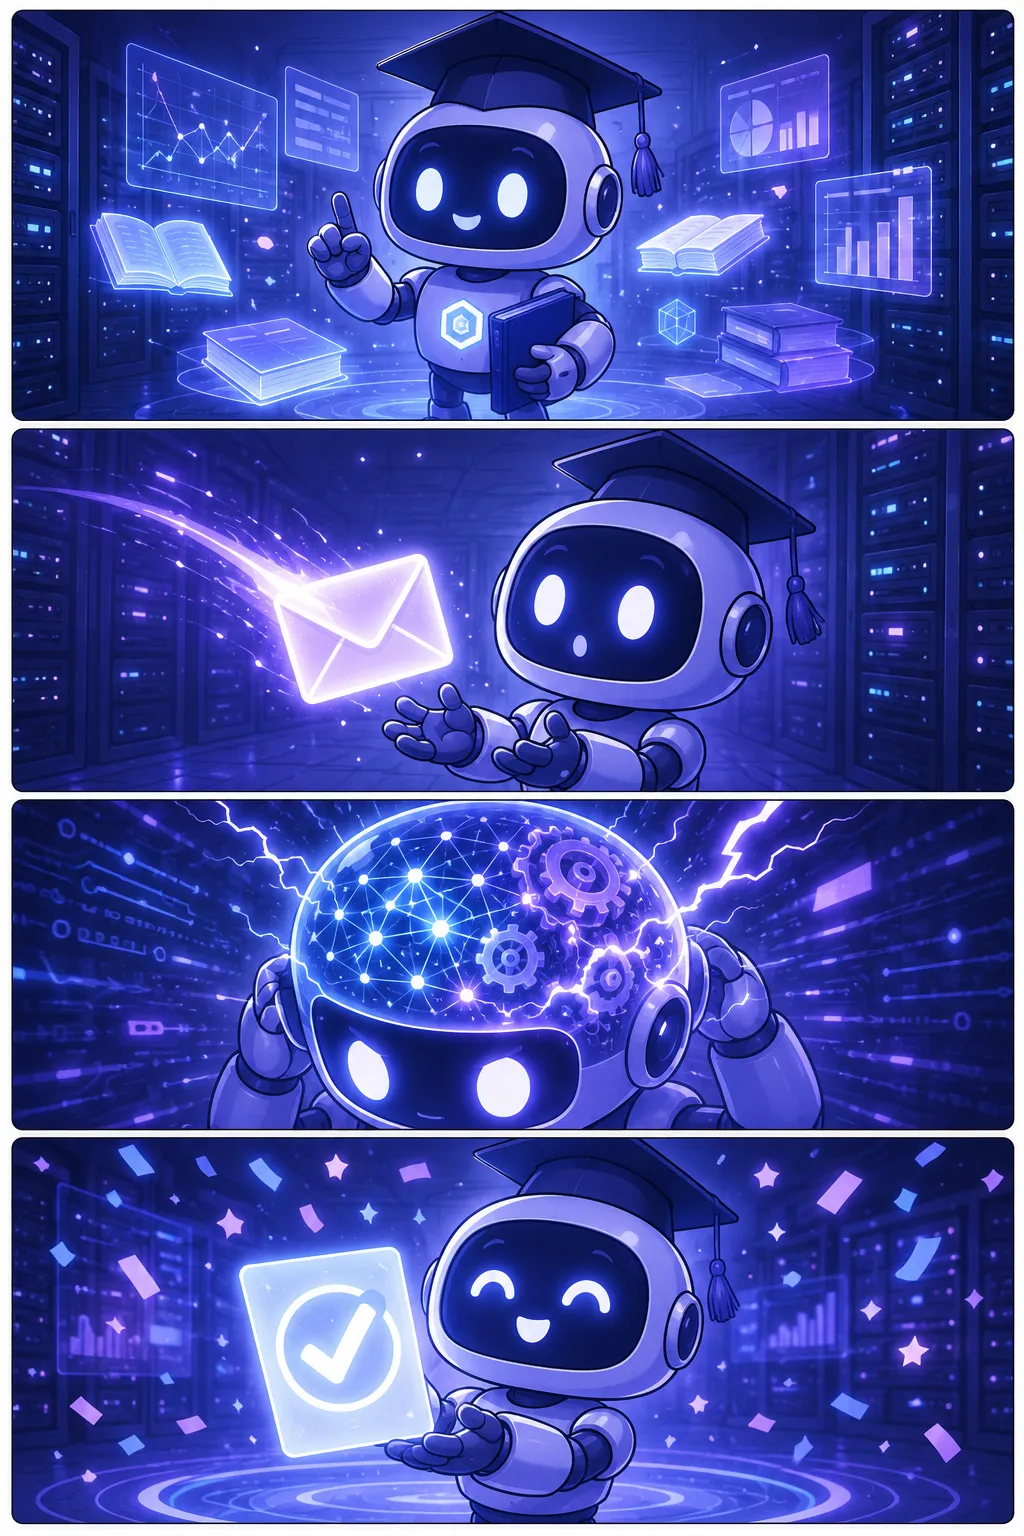
- 1열심히 공부한 AI, 드디어 시험 날!
- 2새로운 문제가 들어온다… 두근두근
- 3학습한 지식을 총동원해 답을 계산!
- 4짠! 정확한 결과를 척척 출력 완료
정의와 배경
추론(Inference)이란 학습이 완료된 AI 모델에 새로운 입력을 넣어 결과를 도출하는 과정을 말한다. 이 추론 방식은 크게 두 가지로 나뉘는데, 사용자 요청이 들어오는 즉시 응답하는 '온라인(실시간) 추론'과, 요청들을 일정 시간 또는 일정 건수 단위로 묶어 한꺼번에 처리하는 '배치 추론'이 그것이다. 배치 추론은 결과 전달에 다소 지연이 발생하더라도 처리량(throughput)을 극대화해야 할 때 선택하는 방식으로, 대용량 데이터를 정기적으로 처리하는 산업 현장에서 오래전부터 활용되어 왔다.
작동 원리와 온라인 추론과의 비교
배치 추론에서는 일정 개수 또는 일정 시간 동안 수집된 입력 데이터를 하나의 '배치(묶음)'로 구성한 뒤, GPU에 일괄 전달하여 병렬로 연산한다. GPU는 병렬 처리에 최적화된 구조이므로, 개별 요청을 하나씩 처리할 때보다 배치 단위로 처리할 때 하드웨어 활용률(utilization)이 높아지고 단위 처리 비용이 낮아진다. 반면 온라인 추론은 응답 지연시간(latency)을 최소화하는 데 초점을 맞추므로, 챗봇·실시간 번역처럼 즉각적인 응답이 필요한 서비스에 적합하다. 배치 추론은 이메일 분류, 대규모 문서 요약, 야간 데이터 분석처럼 결과를 즉시 받지 않아도 되는 작업에 주로 쓰인다.
왜 중요한가
LLM·생성형 AI·파운데이션 모델의 상용화로 AI 추론 수요가 폭발적으로 증가하면서, 제한된 GPU 자원으로 최대 처리량을 달성하는 것이 AIDC 운영의 핵심 과제가 되었다. 배치 추론은 동일한 GPU 인프라에서 처리할 수 있는 요청 수를 늘려 운영 비용을 절감하고, 전력 대비 연산 효율을 높이는 수단으로 주목받는다. 특히 8.4GW 규모의 국내 AIDC 메가프로젝트처럼 대형 인프라 투자가 이루어지는 환경에서는, 어떤 추론 방식을 채택하느냐에 따라 데이터센터의 수익성과 서비스 설계 방식이 달라지기 때문에 정책·사업 기획 단계부터 이를 고려할 필요가 있다.
정책·실무적 시사점
공공기관이나 기업이 AI 서비스를 도입할 때, 서비스 특성에 따라 배치 추론과 온라인 추론을 적절히 혼합 설계하면 GPU 구매·임차 비용을 효과적으로 통제할 수 있다. 예를 들어 민원 서류 자동 분류나 정책 문서 요약처럼 즉각적 응답이 불필요한 업무는 배치 추론으로 처리하고, 실시간 민원 응대 챗봇은 온라인 추론으로 운영하는 방식이 일반적이다. AIDC 구축 및 운영 사업의 조달·계약 단계에서 추론 방식별 처리량과 비용 구조를 명확히 요구사항으로 반영하는 것이 바람직하다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.