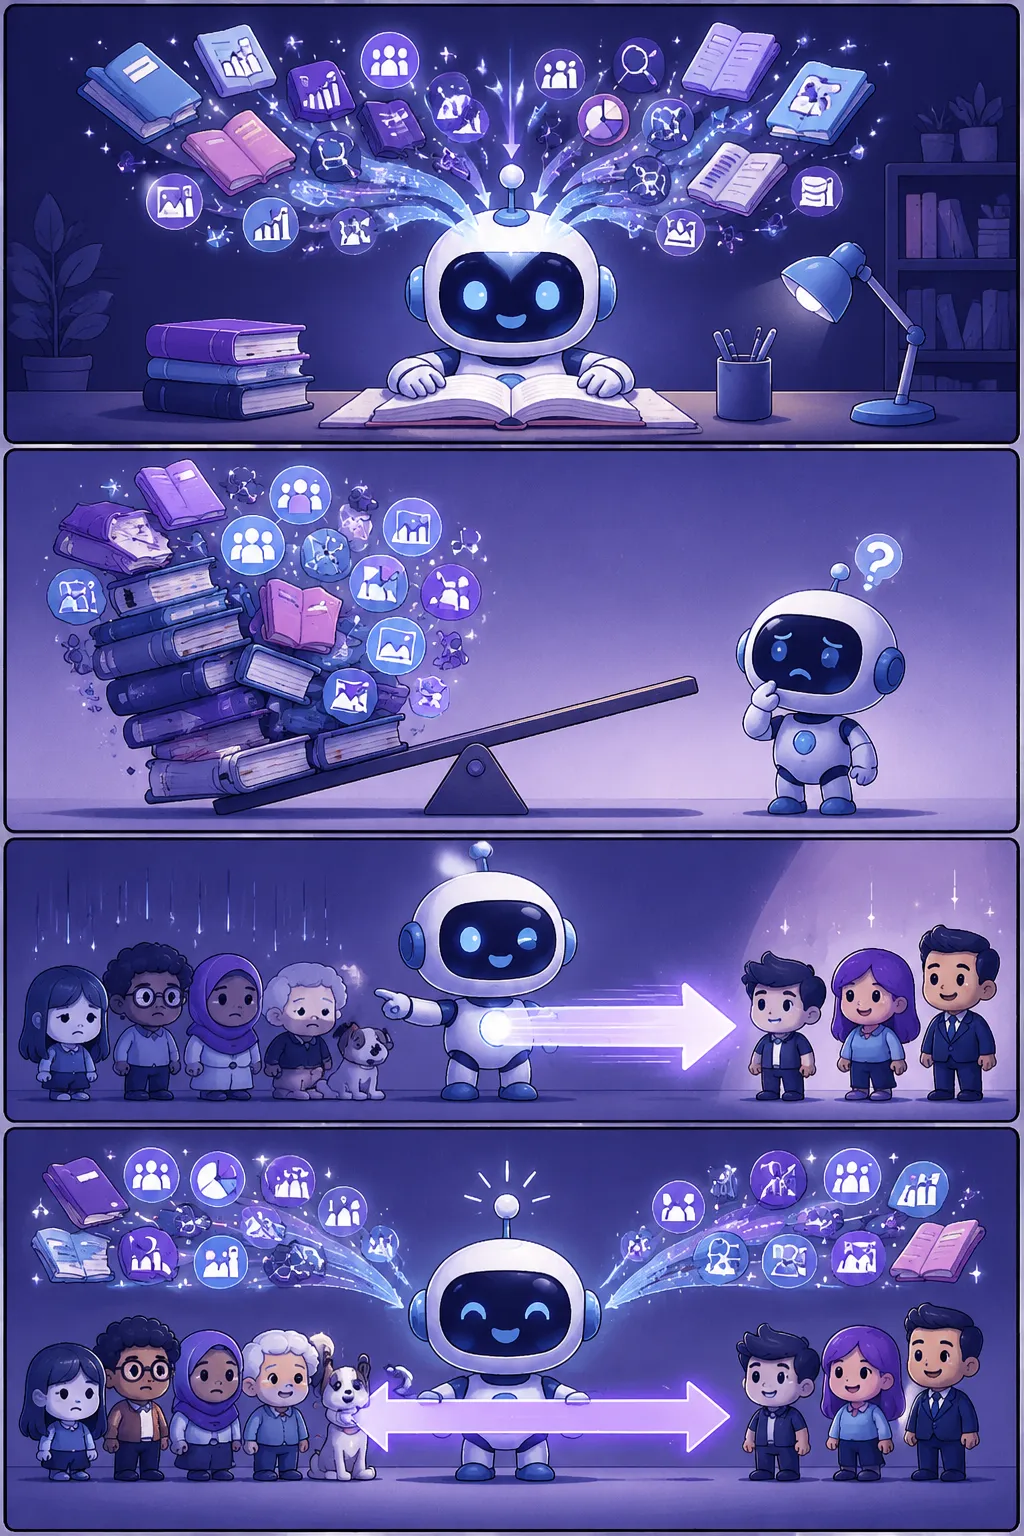
- 1AI가 데이터로 세상을 배워요
- 2근데 데이터가 한쪽으로 기울었다면?
- 3AI 판단도 삐뚤게 나와버려요!
- 4공정한 데이터가 공정한 AI를 만들어요
정의와 배경
데이터 편향은 AI 모델 학습에 사용되는 훈련 데이터가 현실 세계의 다양성을 균형 있게 반영하지 못할 때 발생하는 불균형 상태를 말한다. AI 모델은 입력된 데이터의 통계적 패턴을 학습하기 때문에, 데이터 자체에 특정 성별·인종·지역·언어·연령대 등이 편중되어 있으면 그 편중이 그대로 모델에 내재화된다. 이 개념은 '알고리즘 편향(Algorithmic Bias)'의 가장 직접적인 원인으로 지목되며, AI 윤리 논의에서 공정성 확보의 출발점으로 다루어진다.
주요 유형과 발생 원인
데이터 편향은 크게 세 가지 경로로 발생한다. 첫째, 표본 편향(Sampling Bias)으로, 데이터 수집 단계에서 특정 집단이 과소 대표되는 경우다. 예를 들어 의료 AI 학습 데이터에 특정 인종의 환자 사례가 적으면 해당 집단에 대한 진단 정확도가 낮아질 수 있다. 둘째, 역사적 편향(Historical Bias)으로, 과거의 사회적 차별이나 불평등이 데이터에 그대로 반영되는 경우다. 셋째, 측정 편향(Measurement Bias)으로, 데이터를 수집하거나 레이블링하는 과정에서 주관적 판단이나 오류가 개입될 때 발생한다.
공공 행정에서의 시사점
공공 부문에서 AI를 활용할 때 데이터 편향은 행정의 공정성과 직결되는 문제다. 복지 수급 심사, 채용 필터링, 범죄 예측, 대출 심사 등 의사결정 지원에 AI가 활용될 경우, 편향된 학습 데이터는 특정 시민 집단에 대한 불이익으로 이어질 수 있다. 이에 따라 정부 및 공공기관은 AI 도입 전 학습 데이터의 대표성과 균형을 점검하고, 정기적인 편향 감사(Bias Audit) 절차를 마련하는 것이 권고된다.
데이터 편향을 완화하기 위해서는 다양한 집단을 포괄하는 데이터 수집 전략, 데이터 전처리 단계의 불균형 보정, 그리고 결과물에 대한 지속적인 모니터링이 병행되어야 한다. AI 리터러시 역량 차원에서는, 실무자가 AI 결과물을 무비판적으로 수용하지 않고 편향 가능성을 인식하며 비판적으로 해석하는 태도를 갖추는 것이 핵심이다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.