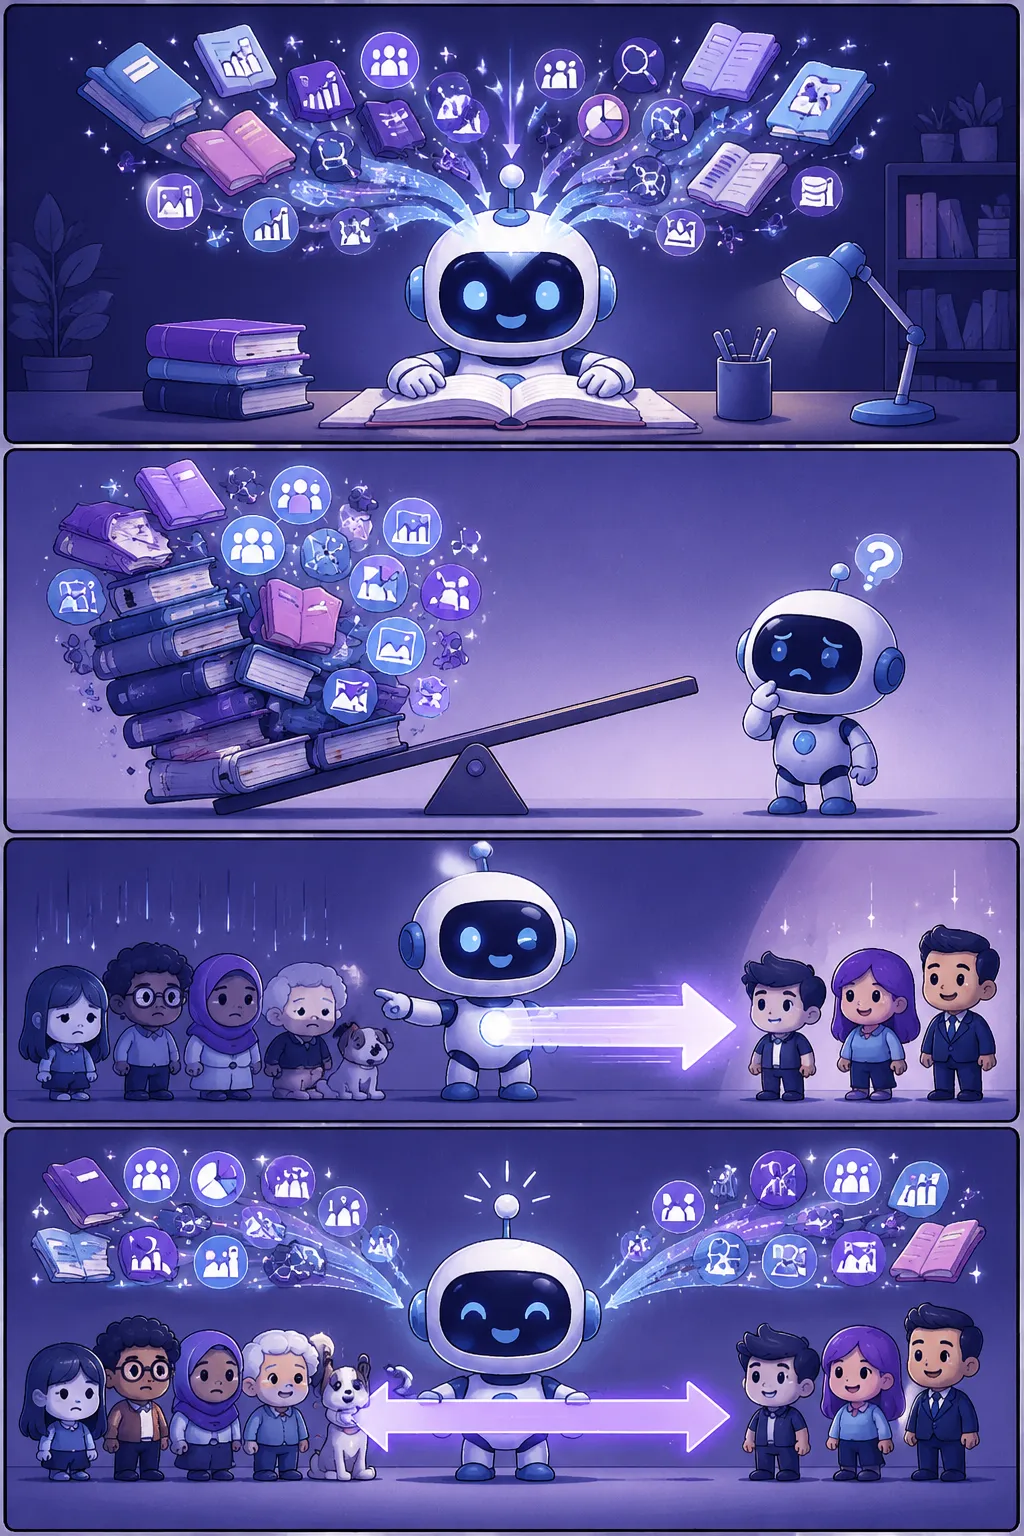
- 1AI가 데이터로 세상을 배워요
- 2근데 데이터가 한쪽으로 기울었다면?
- 3AI 판단도 삐뚤게 나와버려요!
- 4공정한 데이터가 공정한 AI를 만들어요
정의와 배경
성별 편향(Gender Bias)은 AI 시스템이 훈련 데이터에 내재된 성별 관련 고정관념이나 역사적 불균형을 학습함으로써, 특정 성별에 유리하거나 불리한 결과를 산출하는 현상을 말한다. 이는 알고리즘 편향(Algorithmic Bias)의 대표적 하위 유형으로, 데이터 자체의 편향(예: 특정 직종에 남성 데이터가 압도적으로 많음), 레이블링 과정의 편향, 모델 설계자의 암묵적 가정 등 여러 경로를 통해 발생한다.
현실 세계의 데이터는 수십 년간 누적된 사회적 성역할 인식을 반영하는 경우가 많다. 따라서 AI가 이를 그대로 학습하면, 과거의 불평등 구조를 '객관적 패턴'으로 오인하여 미래의 의사결정에 반복 적용하는 악순환이 형성된다.
주요 발현 유형
성별 편향은 분야별로 다양한 형태로 나타난다. 채용 추천 AI가 이력서에서 특정 성별 관련 단어를 감지해 합격률을 차별적으로 조정하거나, 신용 평가 모델이 성별을 간접적으로 반영하는 변수(예: 경력 단절 여부)에 과도한 가중치를 부여하는 사례가 대표적이다.
자연어 처리(NLP) 분야에서는 번역 모델이 '의사'를 남성형으로, '간호사'를 여성형으로 자동 변환하는 문제가 알려져 있으며, 이미지 생성 AI는 '최고경영자(CEO)' 입력 시 특정 성별 이미지를 편향적으로 생성하는 경향이 보고된다. 음성 인식 시스템의 경우 특정 성별·억양의 발화를 더 정확하게 인식하는 성능 격차도 성별 편향의 일종으로 분류된다.
왜 중요한가
AI가 행정, 복지, 교육, 사법 등 공공 의사결정에 점차 활용됨에 따라, 성별 편향이 제도적 차별로 직결될 가능성이 높아지고 있다. 알고리즘 결정은 '중립적·객관적'으로 인식되는 경향이 있어, 인간 심사보다 오히려 편향에 대한 이의제기가 어려울 수 있다.
공무원 및 정책 실무자 입장에서는 공공 AI 시스템 도입 시 성별 편향 여부를 사전에 점검하는 절차(알고리즘 영향 평가)를 설계하고, 학습 데이터의 성별 대표성과 결과 지표의 형평성을 지속적으로 모니터링할 의무가 있다. AI 윤리(AI Ethics) 원칙 중 '공정성' 요건은 성별 편향 최소화를 핵심 과제로 포함한다.
완화 방안과 한계
성별 편향을 완화하기 위한 기술적 접근으로는 학습 데이터 균형화(재샘플링·합성 데이터 보완), 공정성 제약 조건을 반영한 모델 훈련, 사후 결과 보정(Post-processing) 등이 활용된다. 제도적으로는 AI 시스템 도입 전 편향 감사(Bias Audit)를 의무화하고, 성별 분리 통계를 통한 성능 격차 공시를 요구하는 규정이 논의되고 있다.
다만 편향 완화 조치가 또 다른 집단 간 불균형을 야기할 수 있어, 어떤 공정성 기준을 우선할 것인지에 대한 사회적 합의가 선행되어야 한다는 점이 지속적인 과제로 남는다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.