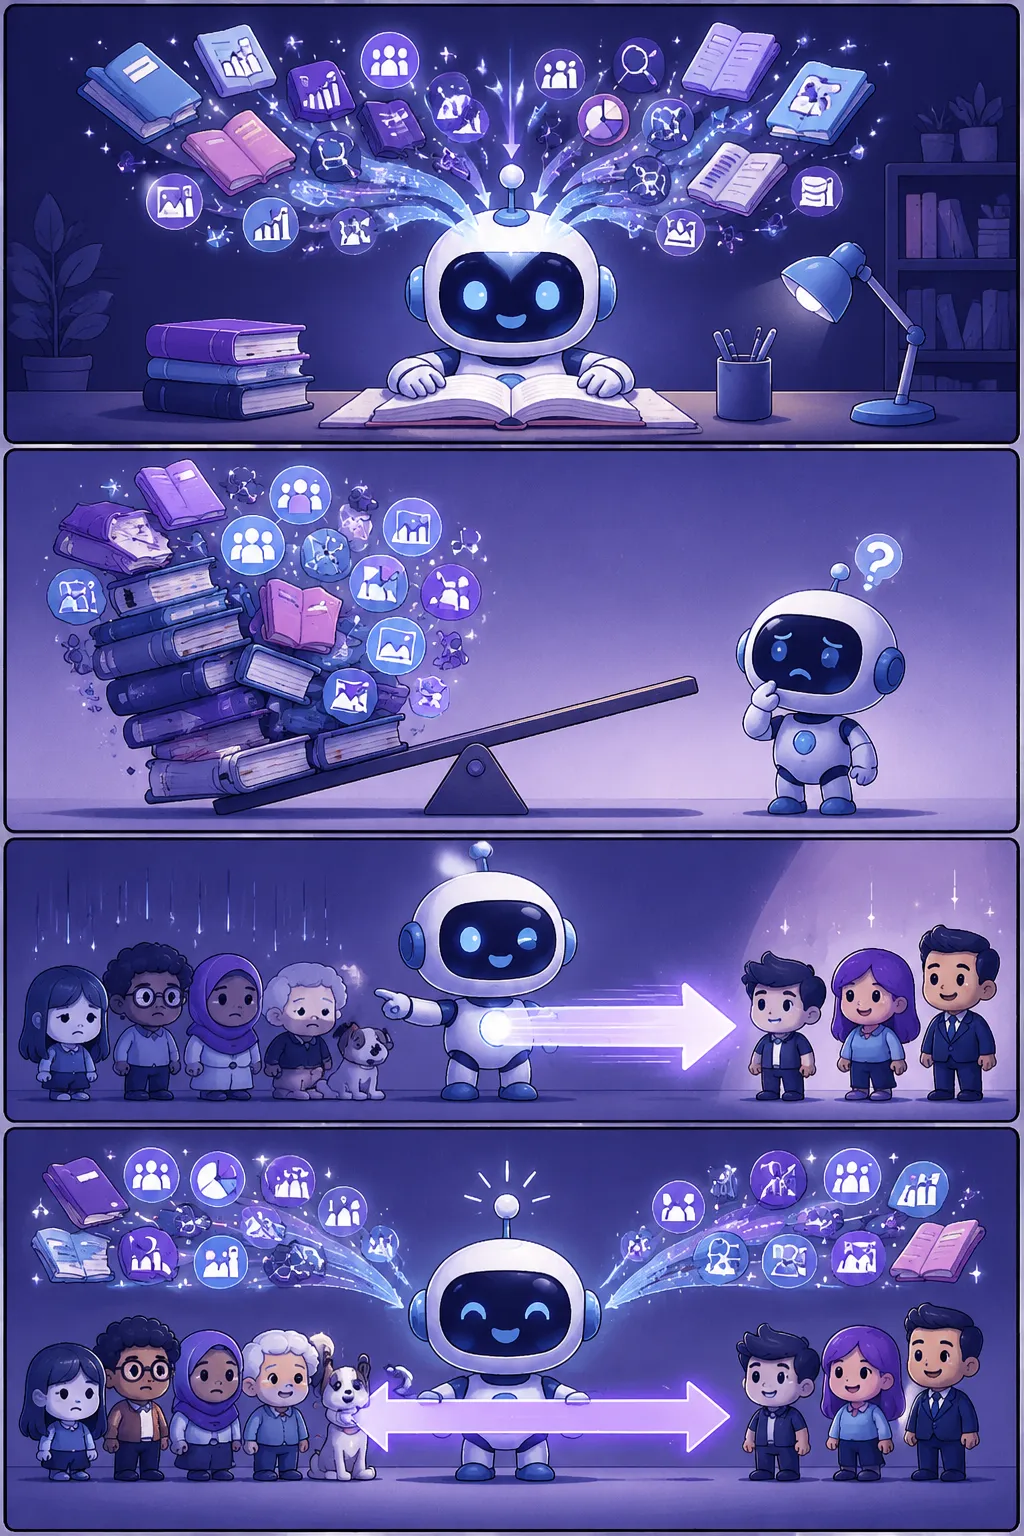
- 1AI가 데이터로 세상을 배워요
- 2근데 데이터가 한쪽으로 기울었다면?
- 3AI 판단도 삐뚤게 나와버려요!
- 4공정한 데이터가 공정한 AI를 만들어요
정의와 배경
AI 공정성이란 인공지능 모델이 성별·연령·인종·지역·소득 등 민감한 속성을 이유로 특정 집단에게 불이익한 결과를 체계적으로 산출하지 않아야 한다는 원칙이다. 이 개념은 AI 학습 데이터에 내재된 사회적 편견이 모델 출력에 그대로 반영되는 '알고리즘 편향' 문제를 해결하려는 논의에서 구체화되었다.
공공 서비스, 금융 심사, 채용 평가, 의료 진단 등 고위험 의사결정 분야에 AI가 도입되면서 불공정한 결과가 사회적 불평등을 심화할 수 있다는 우려가 커졌고, 이에 따라 AI 윤리(AI Ethics)의 핵심 가치 중 하나로 공정성이 부각되었다.
공정성의 주요 유형과 측정 방식
AI 공정성은 단일한 개념이 아니라 여러 기준으로 구분된다. 대표적으로 '집단 공정성(Group Fairness)'은 인구통계학적 집단 간 예측 정확도나 오류율이 유사해야 한다는 기준이며, '개인 공정성(Individual Fairness)'은 유사한 상황의 개인에게 유사한 결과가 주어져야 한다는 기준이다.
이러한 공정성 기준은 서로 동시에 완전히 충족되기 어려운 수학적 트레이드오프 관계에 놓이는 경우가 많아, 어떤 기준을 우선할지는 해당 서비스의 목적과 사회적 맥락에 따라 정책적으로 판단해야 한다. 측정 도구로는 혼동 행렬 기반 지표, 반사실적 공정성 검사 등이 활용된다.
왜 중요한가 — 정책·행정 실무 관점
공공 부문에서 AI를 활용할 때 불공정한 결과는 행정의 신뢰성을 훼손하고 법적 분쟁으로 이어질 수 있다. 특히 복지 수급 심사, 과태료 부과, 범죄 예측 등에서 특정 계층이 반복적으로 불이익을 받는다면 헌법상 평등원칙에 위배될 소지가 있다.
따라서 실무자는 AI 시스템 도입 전 공정성 영향 평가를 실시하고, 학습 데이터의 대표성을 검토하며, 결과 모니터링 체계를 갖추는 것이 권고된다. AI 리터러시(AI Literacy) 역량의 하나로서, 공무원이 공정성 개념을 이해하고 조달·검수 단계에서 관련 기준을 요구할 수 있어야 한다.
관련 개념과의 연계
공정성은 알고리즘 편향을 진단하는 과정에서 도달하는 규범적 목표이며, AI 윤리의 하위 원칙 중 하나다. 할루시네이션이 '사실 정확성'의 문제라면, 공정성은 '형평성'의 문제로 구분할 수 있다.
국내외 AI 규범 문서(EU AI Act, 국내 신뢰할 수 있는 AI 원칙 등)에서는 공정성을 투명성·책임성과 함께 AI 시스템이 갖춰야 할 필수 요건으로 명시하고 있어, 정책 설계와 제도 정비 시 함께 검토되어야 한다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.