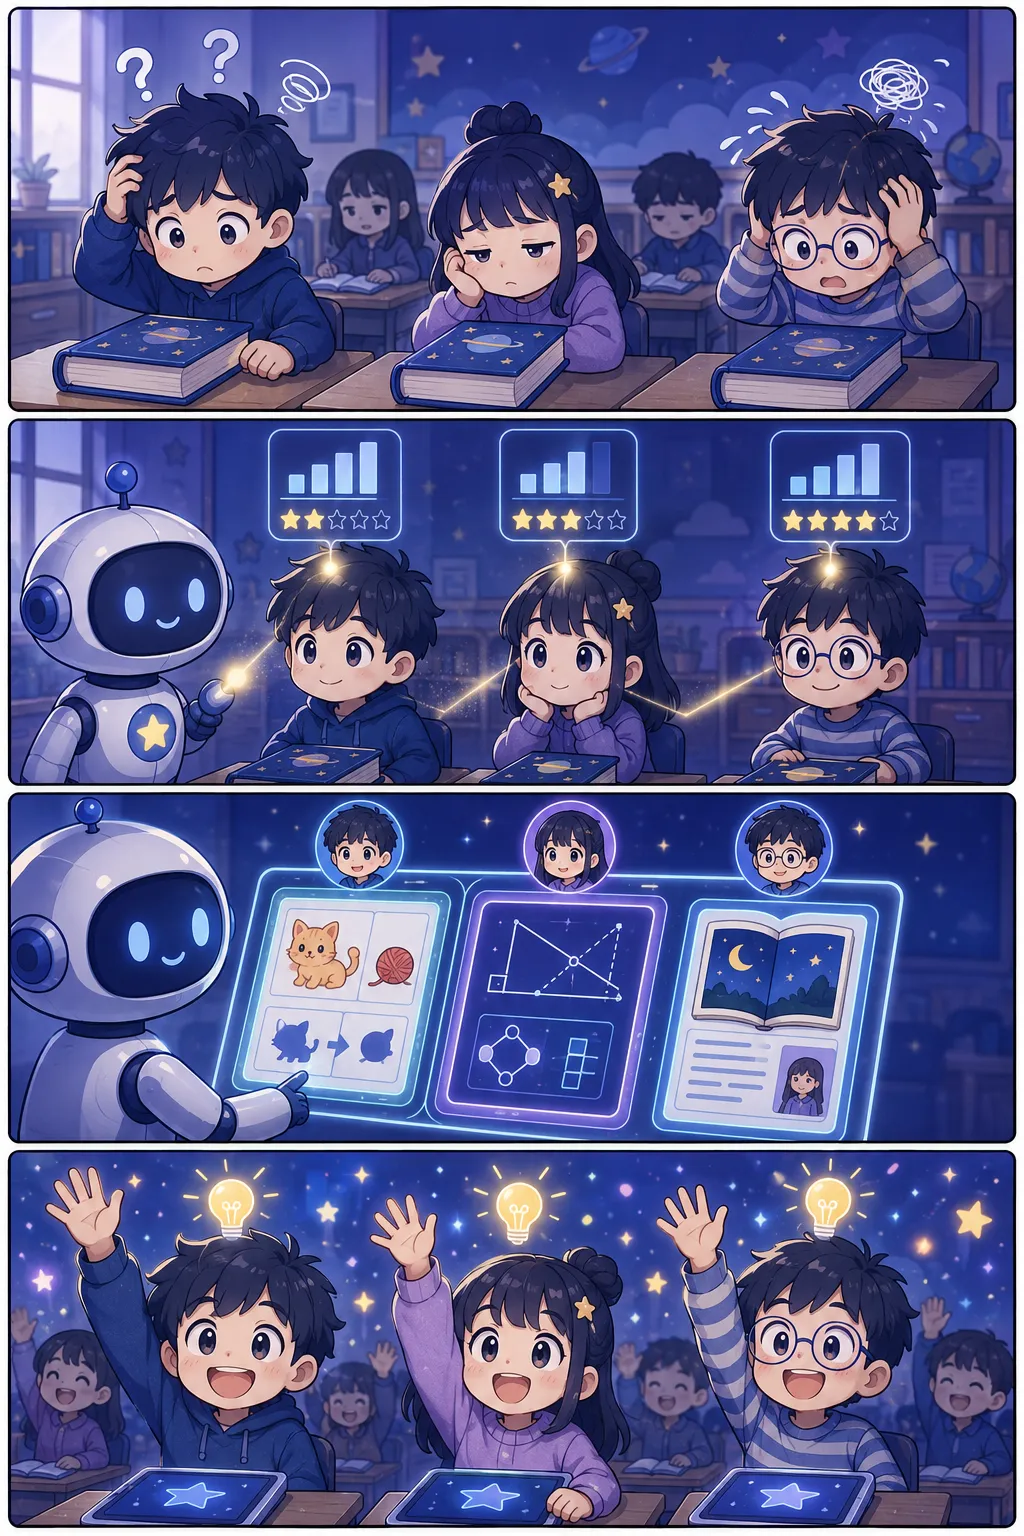
- 11컷: 반 아이들, 모두 같은 문제집 앞에서 표정이 제각각
- 22컷: AI가 각 아이의 수준을 스캔해 데이터로 파악
- 33컷: 아이마다 다른 맞춤 문제가 화면에 쏙쏙 등장
- 44컷: 모두 자기 속도로 '유레카!' 성취감 폭발
정의와 배경
개인화 추천은 사용자가 명시적으로 요청하지 않아도 AI 시스템이 해당 사용자의 이력, 검색 패턴, 클릭·시청 시간, 평가 등 다양한 데이터를 학습하여 관심 가능성이 높은 항목을 자동으로 제시하는 방식이다. 인터넷 서비스가 폭발적으로 확장되면서 이용자가 방대한 정보 중 원하는 것을 직접 탐색하는 데 드는 비용이 커졌고, 이를 줄이기 위한 기술적 해결책으로 발전했다. 교육 분야에서는 학습자의 수준·속도·관심사에 맞는 학습 자료를 자동 제공하는 맞춤형 학습의 핵심 도구로 활용된다.
작동 원리와 주요 방식
개인화 추천의 대표적 기법으로는 협업 필터링(Collaborative Filtering), 콘텐츠 기반 필터링(Content-based Filtering), 그리고 두 방식을 결합한 하이브리드 방식이 있다. 협업 필터링은 유사한 행동 패턴을 보인 다른 사용자들의 선택을 참고해 추천하며, 콘텐츠 기반 필터링은 사용자가 과거에 선호한 항목의 속성을 분석해 유사 항목을 제안한다. 최근에는 딥러닝과 자연어 처리 기술이 결합되어 더 세밀한 문맥 이해를 바탕으로 추천 정확도가 높아지고 있다.
AI 리터러시 관점에서의 중요성
개인화 추천은 편의를 제공하는 동시에 이용자가 인식하지 못하는 사이에 정보 노출 범위를 좁히는 필터 버블(Filter Bubble) 현상을 유발할 수 있다. 알고리즘 편향이 학습 데이터에 내재된 경우 특정 집단·관점이 과대 또는 과소 추천되는 문제도 발생한다. 따라서 공무원·정책 실무자 등이 AI 서비스를 활용하거나 관련 정책을 수립할 때, 추천 결과를 무비판적으로 수용하지 않고 그 배경 원리와 한계를 이해하는 AI 리터러시 역량이 필수적이다.
정책·행정 현장에서의 유의점
공공 서비스 분야에서도 민원 안내, 복지 서비스 연계, 공공 교육 플랫폼 등에 개인화 추천 기술 도입이 확대되고 있다. 이 경우 개인정보 수집·활용 범위, 데이터 보안, 알고리즘 투명성 확보가 핵심 과제이며, AI 윤리 기준에 따른 설계와 운영이 요구된다. 추천 시스템이 특정 정책 정보나 서비스만을 반복 노출할 경우 행정 서비스의 형평성에 영향을 미칠 수 있으므로, 도입 시 공정성 검토와 이용자 선택권 보장 방안을 함께 마련해야 한다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.