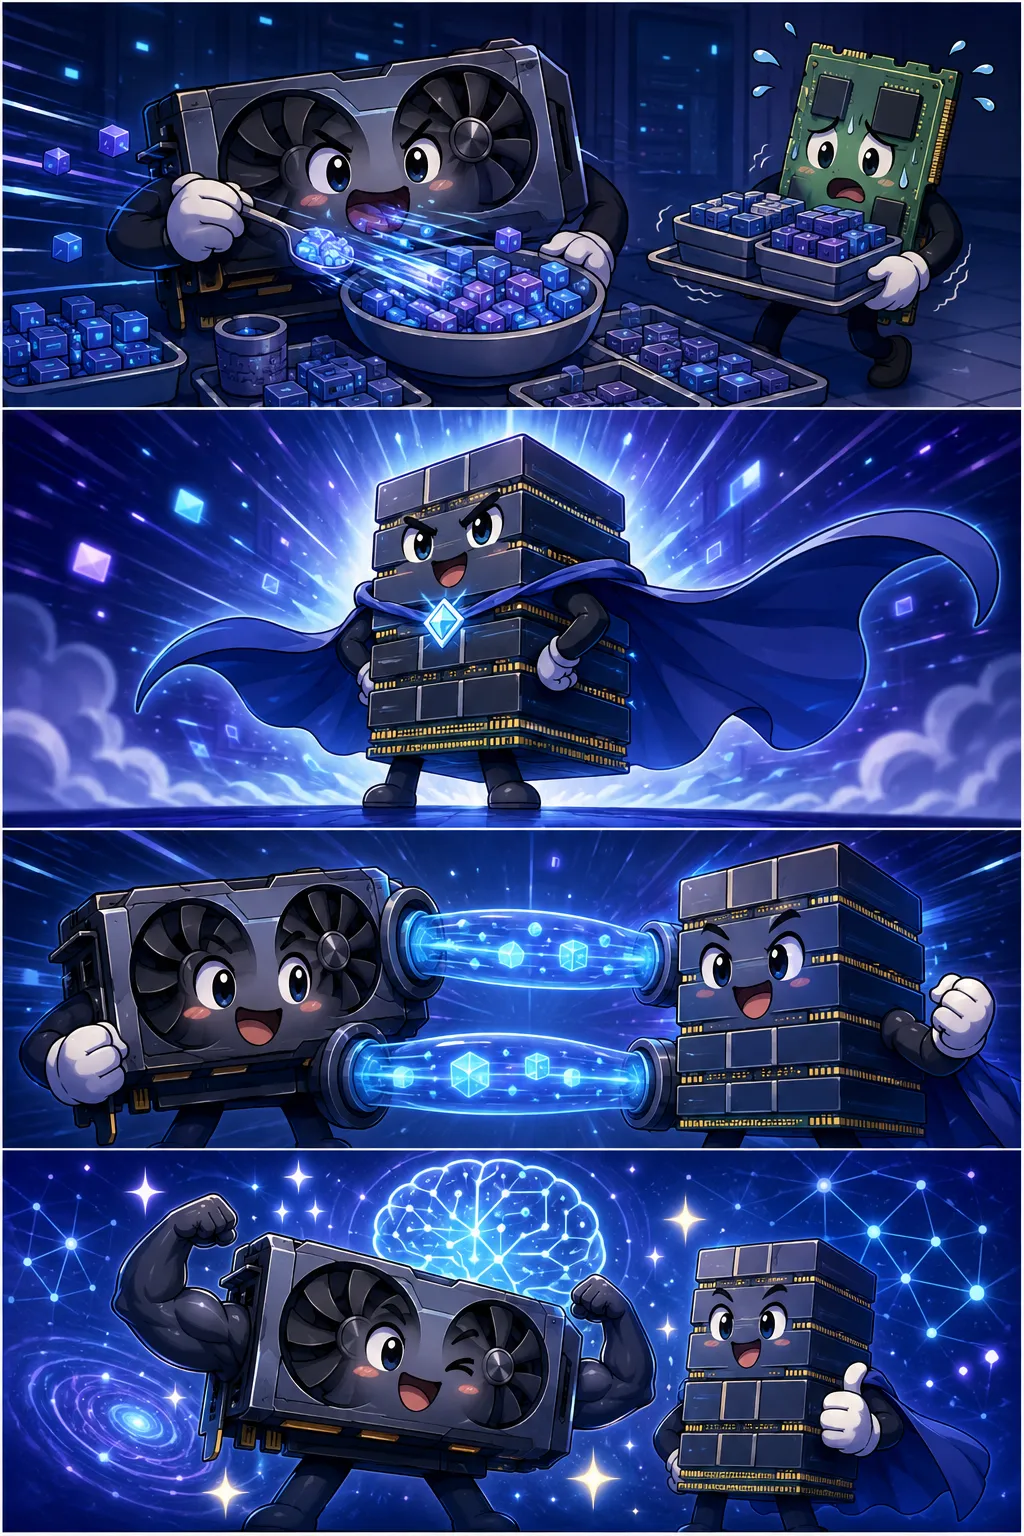
- 11컷: GPU가 밥을 엄청 빨리 먹는데… 일반 메모리가 너무 느려!
- 22컷: 해결사 등장! HBM, 초고속 적층 메모리!
- 33컷: GPU 옆에 딱 붙어 초고속으로 데이터를 전달하는 HBM
- 44컷: AI 연산이 쌩쌩~! HBM 없인 AI도 없다!
정의와 배경
HBM4는 JEDEC(반도체 국제 표준기구)의 HBM 표준 로드맵상 4세대에 해당하는 고대역폭메모리 규격이다. HBM은 수십 개의 D램 다이(Die)를 수직으로 적층하고 실리콘 관통 전극(TSV, Through-Silicon Via)으로 연결해 기존 GDDR 방식 대비 수배 이상의 대역폭을 제공하는 구조로 설계된다.
HBM 세대는 HBM1→HBM2→HBM2E→HBM3→HBM3E→HBM4 순으로 발전해 왔으며, 각 세대마다 메모리 대역폭과 적층 단수, 인터페이스 폭이 확대되어 왔다. AI 연산에 쓰이는 GPU·NPU가 처리해야 할 데이터량이 폭발적으로 증가하면서, 메모리 성능이 전체 AI 시스템 성능의 핵심 제약 요소로 부상한 것이 HBM4 개발의 직접적 배경이다.
주요 기술 특성과 개선 방향
HBM4는 이전 세대 대비 메모리 대역폭과 단위 면적당 용량을 크게 끌어올리는 것을 핵심 목표로 한다. 구체적으로는 스택당 적층 단수를 늘리고(예: 12단 이상), 입출력(I/O) 핀 수 및 동작 속도를 높여 초당 수 테라바이트(TB/s) 수준의 대역폭을 목표로 한다.
또한 HBM4부터는 로직 다이(Logic Die) 설계의 커스터마이징 허용 범위가 넓어질 것으로 업계는 예상한다. 이는 엔비디아·AMD 등 GPU 설계사나 대형 클라우드 기업이 자사 AI 칩 특성에 최적화된 메모리 사양을 요구할 수 있게 됨을 의미하며, 메모리 공급사와 시스템 반도체 설계사 간 협력 구조가 이전보다 긴밀해진다.
왜 중요한가 — AI 산업 및 정책적 의미
AI 대형 언어모델(LLM)이나 멀티모달 모델을 훈련·추론할 때 GPU 내 연산 유닛이 아무리 빠르더라도 메모리 대역폭이 부족하면 전체 시스템 성능이 병목에 걸린다. HBM4는 이 병목을 완화해 AI 클러스터의 실질 처리 능력을 높이는 핵심 부품이다.
대한민국은 삼성전자·SK하이닉스가 HBM 시장을 주도하고 있어 HBM4 양산 기술력이 국가 반도체 경쟁력과 직결된다. 정부의 반도체 메가프로젝트(800조) 역시 차세대 메모리 기술 확보를 위한 팹 증설, 소부장 내재화, 클러스터 조성을 지원하고 있으며, HBM4 관련 TSV 공정·고급 패키징 장비·소재 분야 국산화가 주요 정책 과제로 다루어진다.
반도체 메가프로젝트 맥락
정부의 반도체 메가프로젝트는 수도권 및 지방 반도체 클러스터를 통해 HBM4 같은 차세대 메모리를 포함한 첨단 반도체의 국내 생산 기반을 구축하는 것을 목표로 한다. 팹 건설에 소요되는 대규모 투자와 더불어, HBM4 생산에 필요한 고순도 화학 소재·고정밀 식각 장비·첨단 패키징 장비 등 소부장 산업 생태계 강화가 병행 추진된다.
HBM4는 엔비디아 등 글로벌 AI 가속기 업체와의 기술 협력 및 공급망 연계가 필수적이어서, 국내 반도체 기업의 HBM4 기술 확보 여부는 글로벌 AI 공급망에서 한국의 위상을 결정짓는 중요한 변수로 평가된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.