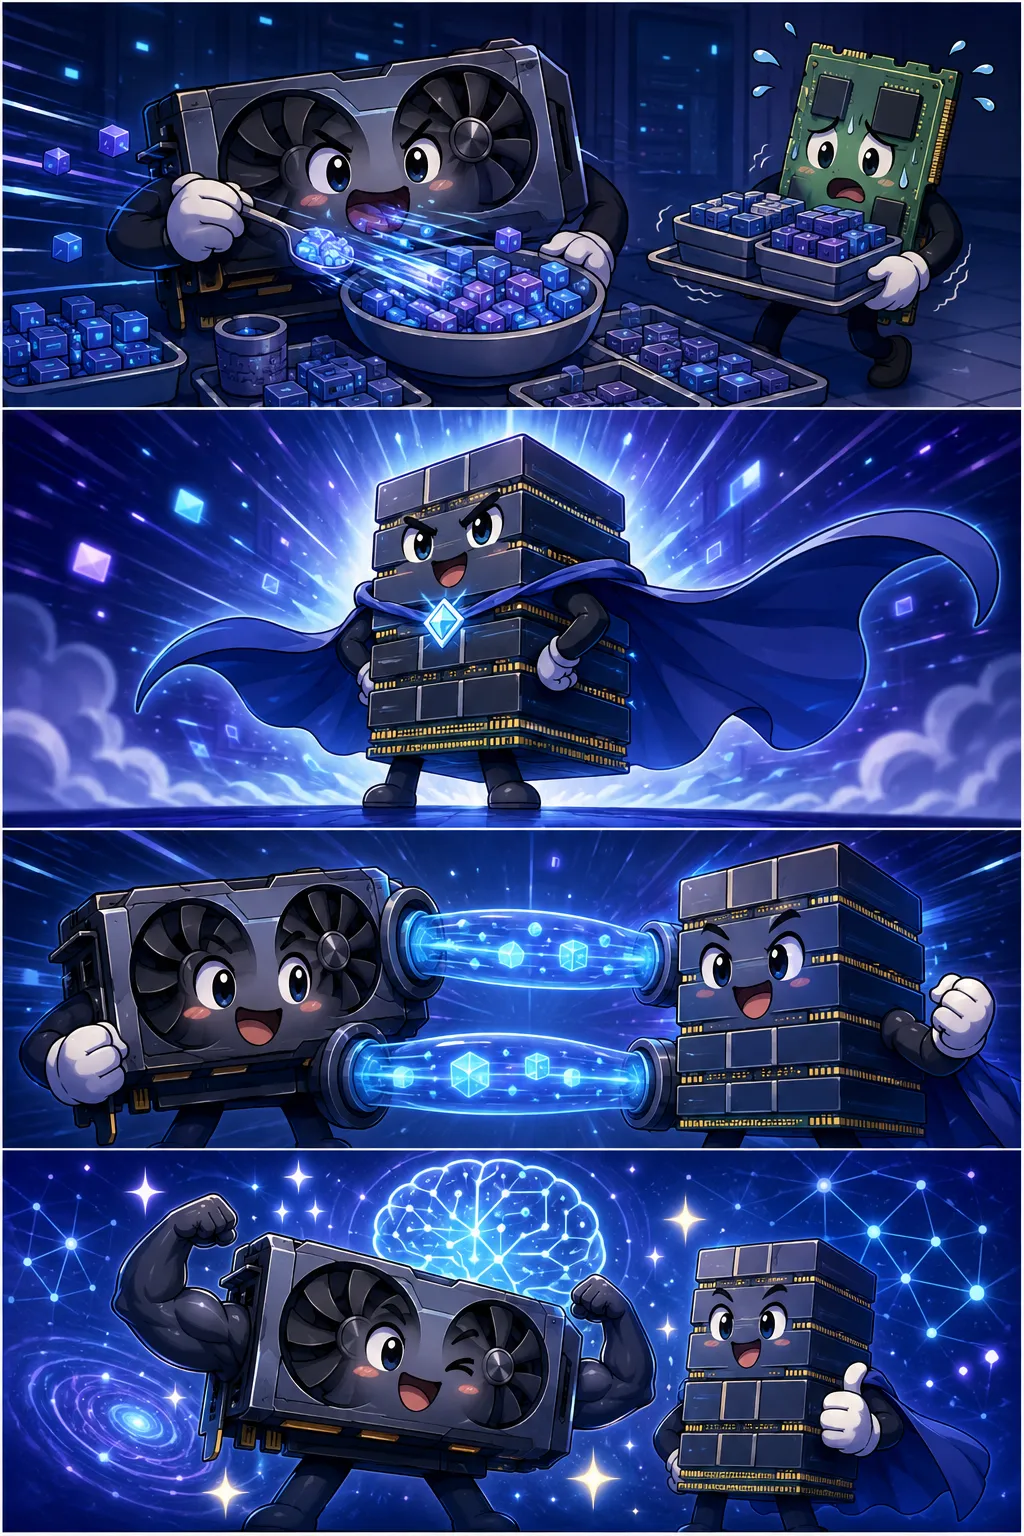
- 11컷: GPU가 밥을 엄청 빨리 먹는데… 일반 메모리가 너무 느려!
- 22컷: 해결사 등장! HBM, 초고속 적층 메모리!
- 33컷: GPU 옆에 딱 붙어 초고속으로 데이터를 전달하는 HBM
- 44컷: AI 연산이 쌩쌩~! HBM 없인 AI도 없다!
정의와 배경
HBM 스택이란 HBM 메모리 반도체를 제조할 때 복수의 DRAM 다이를 수직 방향으로 층층이 쌓은 구조, 또는 그 적층 공정 자체를 가리키는 용어다. 일반 DRAM이 평면(2D) 구조로 메모리 셀을 배치하는 것과 달리, HBM 스택은 실리콘 관통 전극(TSV, Through-Silicon Via)이라는 미세 수직 배선을 이용해 각 다이를 전기적으로 연결한다. 이 방식은 반도체 집적도를 극적으로 높이면서도 칩 면적을 최소화할 수 있어, 면적과 전력 소모에 민감한 AI 가속기 설계에 필수적인 구조로 자리잡았다.
작동 원리와 주요 특성
HBM 스택의 핵심은 TSV 기술로, 각 DRAM 다이에 수백~수천 개의 미세 구멍을 뚫어 수직 도선을 형성함으로써 다이 간 신호를 매우 짧은 경로로 전달한다. 적층되는 다이 수가 많아질수록(예: 4단→8단→12단 이상) 용량과 대역폭이 늘어나지만, 방열 및 적층 정렬 정밀도 관리가 더욱 어려워진다. 최하단에는 논리 연산 및 인터페이스 제어를 담당하는 베이스 다이(Base Die)가 위치하며, 완성된 스택은 GPU·NPU 등 연산 칩과 함께 인터포저 기판 위에 나란히 실장되는 방식(HBM+GPU 패키지)으로 최종 제품화된다. 이 구조 전체를 아우르는 패키징 기술을 2.5D 또는 3D 패키징이라 부르며, 생산 과정에서 팹(Fab)의 공정 정밀도와 소부장 품질이 수율을 좌우한다.
왜 중요한가
AI 대형 모델 학습·추론에는 방대한 양의 데이터를 GPU와 메모리 사이에서 빠르게 주고받는 것이 병목 해소의 관건인데, HBM 스택 구조는 기존 GDDR 메모리 대비 수 배~수십 배 높은 대역폭을 제공함으로써 이 병목을 완화한다. 스택 층수가 늘어날수록 더 많은 AI 연산을 더 짧은 시간 안에 처리할 수 있어, HBM 세대 경쟁(HBM2→HBM3→HBM3E 등)은 곧 AI 반도체 성능 경쟁과 직결된다. 한국 반도체 기업들이 HBM 스택 기술에서 세계적 경쟁력을 보유하고 있어, 정부의 반도체 메가프로젝트(800조) 투자 전략에서도 HBM 생산 역량 확충과 관련 소부장 공급망 내재화가 핵심 과제로 다루어진다.
반도체 메가프로젝트 맥락
대한민국 반도체 메가프로젝트는 팹 신증설, 반도체 클러스터 조성, 소부장 자립화를 3대 축으로 삼고 있으며, HBM 스택 기술은 그 중심에 놓여 있다. HBM 스택 생산에는 TSV 공정 장비, 초정밀 본딩 소재, 고순도 공정 화학품 등 고도화된 소부장이 필수적이어서, 관련 국내 공급망 육성이 정책적 관심 대상이다. 또한 TSMC 등 해외 파운드리와의 패키징 협력 구도에서 한국 기업의 HBM 스택 독자 경쟁력은 기술 주권 차원에서 중요한 의미를 가지며, 공무원·정책 실무자 입장에서는 수출 통제 규범, 공급망 리스크 관리, R&D 투자 우선순위 결정 시 반드시 이해해야 할 개념이다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.