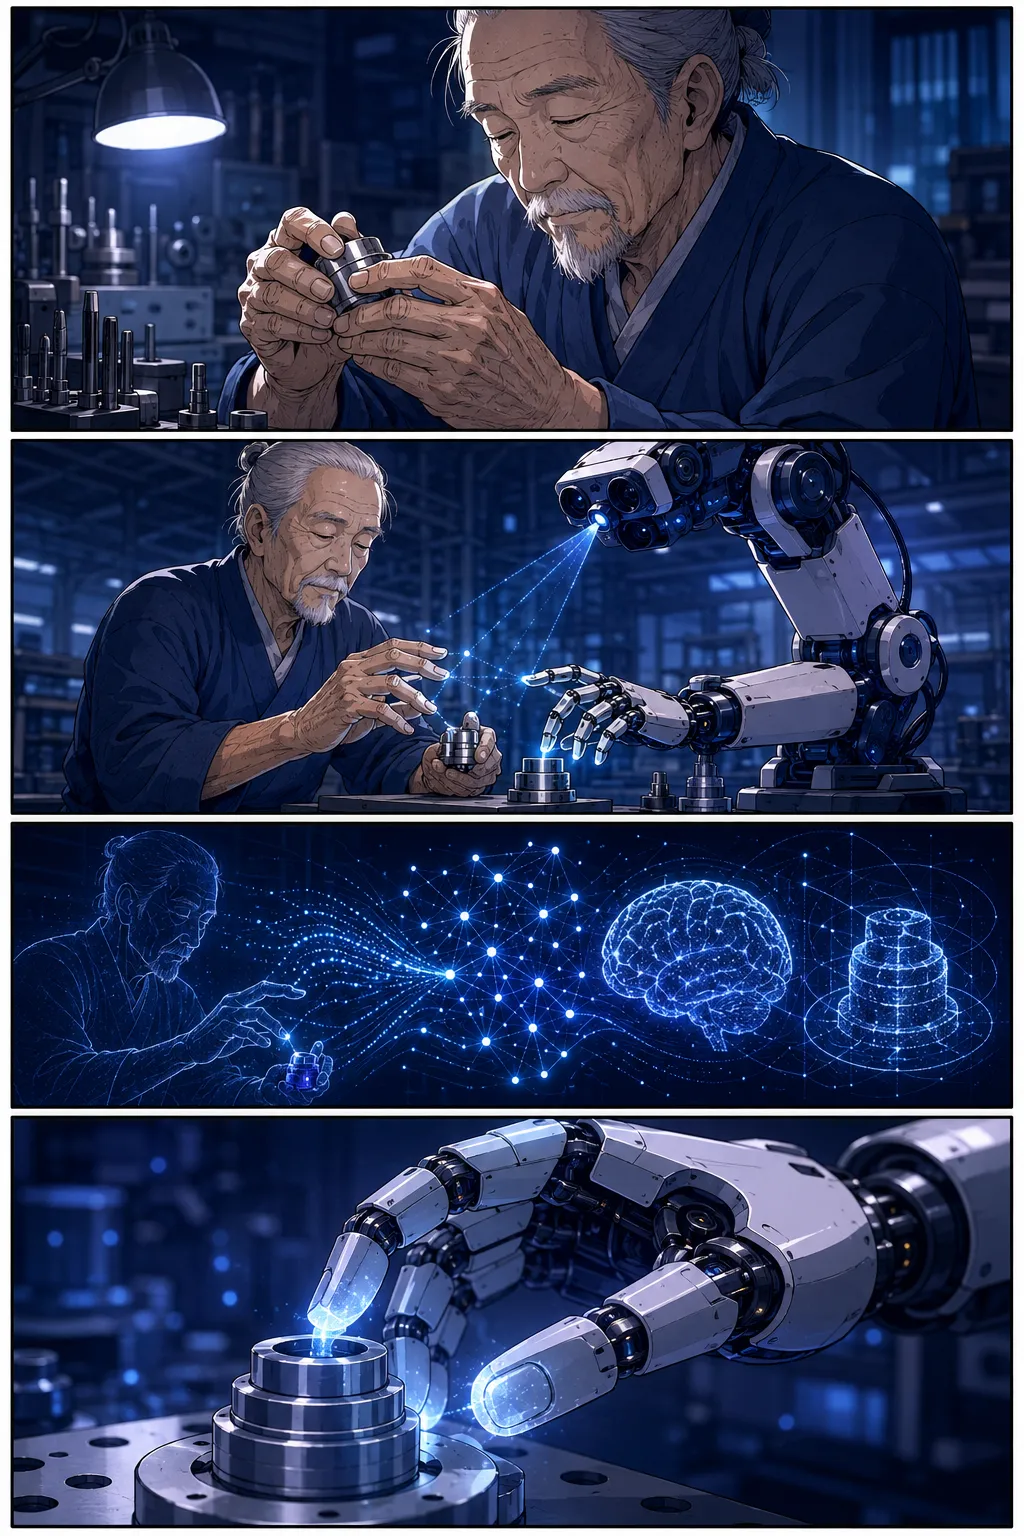
- 140년 장인, 손끝으로 품질을 느낀다
- 2로봇이 그 손동작을 몰래 배운다
- 3수천 번의 데이터로 노하우가 쌓인다
- 4이제 로봇 손끝에도 장인의 감각이!
정의와 배경
데이터 라벨링이란 이미지·영상·텍스트·센서 신호 등 비정형 원시 데이터에 AI 모델이 인식·판단할 수 있도록 분류명, 경계 상자, 좌표, 상태값 등의 정보를 체계적으로 부착하는 작업을 말한다. 지도학습(Supervised Learning) 기반의 AI 모델은 정답이 명시된 학습 데이터 없이는 훈련될 수 없으므로, 데이터 라벨링은 AI 개발의 가장 기초적이고 필수적인 단계로 간주된다.
피지컬 AI 맥락에서 데이터 라벨링은 단순한 이미지 분류를 넘어, 로봇이 물리 환경에서 수행하는 조립·파지·이동 등의 동작 시퀀스와 제조 숙련공의 암묵지(Tacit Knowledge)를 구조화된 데이터로 전환하는 과정까지 포함한다.
피지컬 AI·제조 현장에서의 작동 방식
로봇 학습용 데이터 라벨링은 카메라·LiDAR·촉각 센서·토크 센서 등 복수의 입력 소스에서 수집된 멀티모달 데이터를 대상으로 한다. 예를 들어 용접·조립 공정을 촬영한 영상에는 부품 위치, 공구 궤적, 작업자 손 동작, 불량 여부 등을 태깅하며, 이렇게 구축된 데이터셋이 제조AI 파운데이션 모델이나 월드모델의 훈련에 투입된다.
숙련공의 암묵지를 라벨링하는 과정은 특히 난도가 높다. 경험에서 비롯된 미세한 힘 조절, 시각적 판단 기준, 상황별 의사결정 등은 언어화되지 않은 지식이므로, 전문가 인터뷰·동작 포착(Motion Capture)·생체신호 측정 등 다양한 방법으로 데이터를 수집한 뒤 전문 인력이 의미 단위로 구조화·주석 처리한다.
왜 중요한가
데이터 라벨링의 품질은 AI 모델 성능의 상한선을 결정한다고 알려져 있다. 라벨이 불정확하거나 편향되어 있으면 아무리 정교한 모델 아키텍처를 사용해도 현장 적용 성능이 저하되며, 제조·의료·물류 등 안전 임계 환경에서는 오작동으로 이어질 수 있다.
피지컬 AI 메가프로젝트 관점에서 고품질 제조 라벨링 데이터는 국가 차원의 경쟁 자산이 된다. 특정 공정·소재·장비에 특화된 라벨 데이터를 대량으로 확보한 국가나 기업은 해당 영역의 AI 모델 개발에서 구조적 우위를 가질 수 있기 때문이다. 이에 따라 공공·민간이 협력하여 표준화된 라벨링 체계와 플랫폼을 구축하는 것이 정책 과제로 부상하고 있다.
한계와 향후 과제
전통적인 수작업 라벨링은 시간·비용이 많이 들고 일관성을 유지하기 어렵다는 한계가 있다. 이를 보완하기 위해 반자동 라벨링 도구, 능동 학습(Active Learning), 합성 데이터(Synthetic Data) 생성, 시뮬레이션 기반 자동 라벨링 등의 기술이 발전하고 있으며, 디지털 트윈 환경에서 가상으로 생성한 데이터에 자동 라벨을 부여하는 방식도 활용된다.
국내 정책 측면에서는 제조 현장별로 상이한 공정 용어와 데이터 형식을 표준화하고, 중소 제조기업도 참여할 수 있는 공동 라벨링 인프라를 조성하는 것이 피지컬 AI 생태계 확장을 위한 선결 과제로 꼽힌다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.