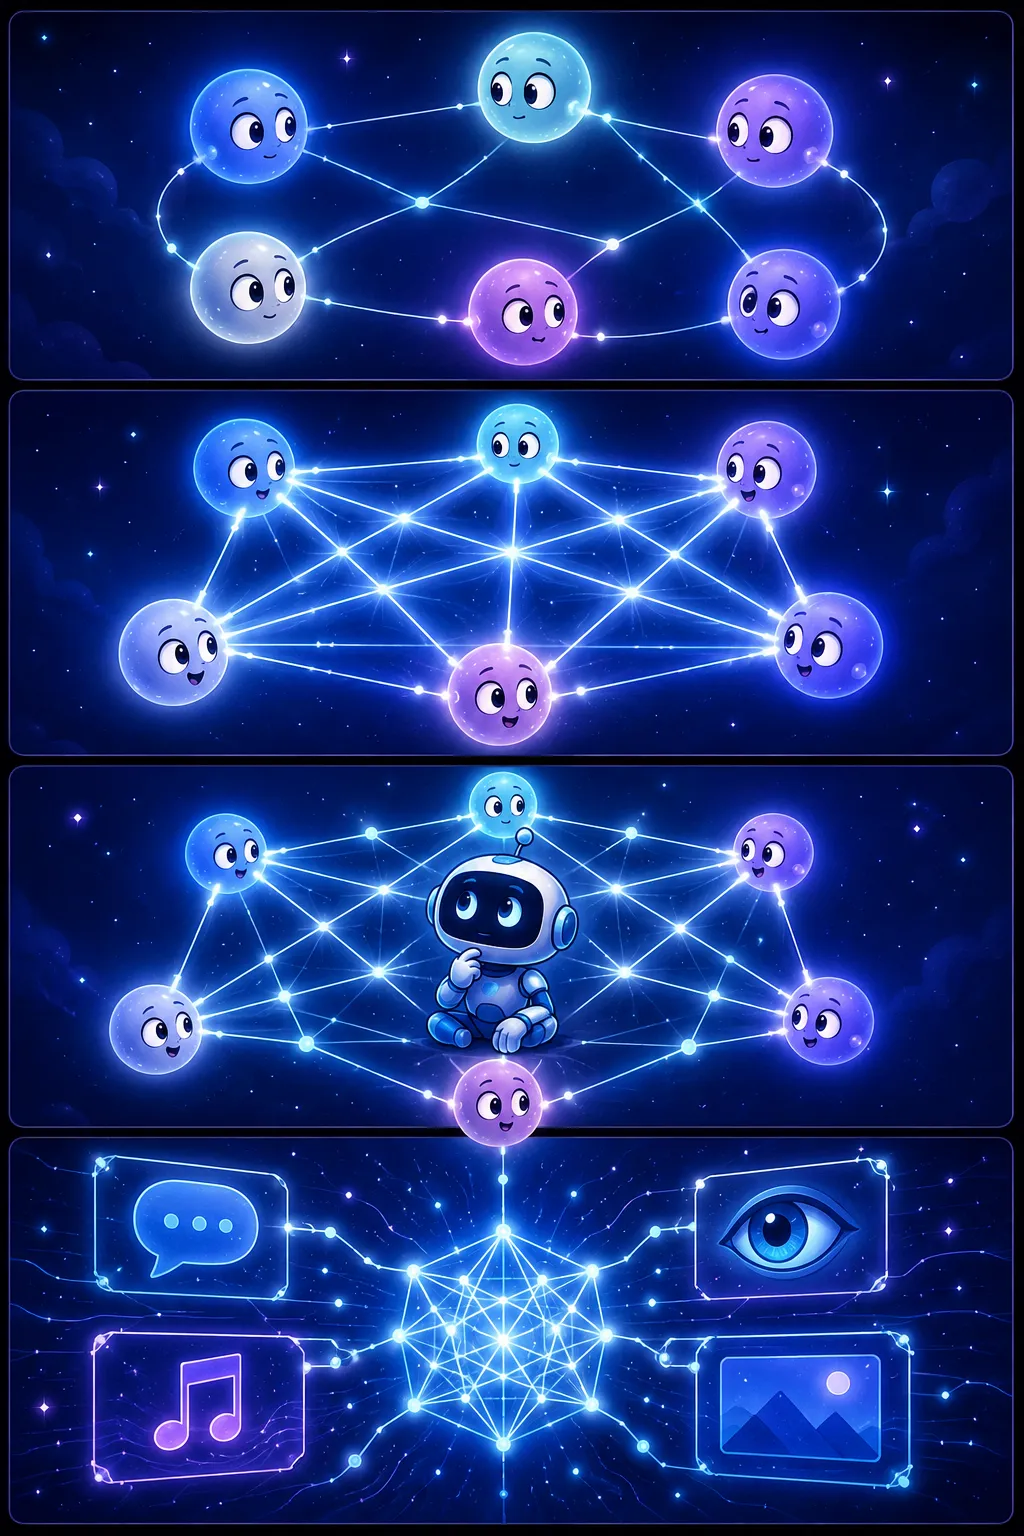
- 11컷: 단어들이 서로를 바라보다
- 22컷: 모두가 동시에 연결되다
- 33컷: 순서 대신 관계로 이해하다
- 44컷: 세상 모든 AI의 뼈대가 되다
정의와 배경
Transformer는 딥러닝의 한 모델 구조로, 입력 데이터의 각 요소가 다른 모든 요소와 얼마나 관련 있는지를 수치화하는 '셀프 어텐션(Self-Attention)' 메커니즘을 기반으로 작동한다. 이전까지 자연어 처리의 주류였던 순환 신경망(RNN)·장단기 기억망(LSTM)은 문장을 순서대로 처리해야 했기 때문에 속도가 느리고 긴 문맥을 기억하기 어려웠다. Transformer는 이 순차 처리 방식을 병렬 처리로 대체함으로써 학습 속도와 장거리 의존성 포착 능력을 동시에 개선했다.
'Attention Is All You Need'라는 제목의 논문에서 처음 제안되었으며, 이후 BERT·GPT·T5 등 현재 널리 쓰이는 대규모 언어 모델(LLM)의 공통 기반 구조가 되었다.
작동 원리와 주요 구성 요소
Transformer는 크게 인코더(Encoder)와 디코더(Decoder)로 구성된다. 인코더는 입력 문장 전체를 받아 각 단어의 문맥 정보를 압축된 벡터로 변환하고, 디코더는 이를 바탕으로 출력 문장을 생성한다. 셀프 어텐션 계층에서는 각 단어가 문장 내 모든 다른 단어와의 관련성 점수(가중치)를 계산하여, 멀리 떨어진 단어 간 관계도 즉각적으로 반영한다.
위치 인코딩(Positional Encoding)은 병렬 처리 과정에서 사라지는 단어 순서 정보를 보완하기 위해 도입된 장치다. 실제 적용 형태에 따라 인코더만 사용하는 BERT 계열, 디코더만 사용하는 GPT 계열, 둘 다 사용하는 T5·번역 모델 등으로 구분된다.
확장과 현대적 의의
Transformer는 자연어 처리에서 출발했지만, 이후 이미지 인식(Vision Transformer, ViT), 음성 인식, 단백질 구조 예측 등 다양한 도메인으로 적용 범위가 확대되었다. 이는 멀티모달 AI의 기술적 토대를 마련하는 데 핵심 역할을 했으며, 서로 다른 데이터 형식을 하나의 통합 구조로 처리하는 범용 AI 모델 설계를 가능하게 했다.
정책·산업 실무 관점에서 Transformer의 중요성은 GPU 등 고성능 병렬 연산 인프라 수요를 폭발적으로 증가시킨 직접적 원인이라는 점에 있다. 국가 AI 컴퓨팅 인프라 투자, 반도체 정책 등을 검토할 때 Transformer 기반 모델의 연산 특성을 이해하는 것이 실무적으로 유용하다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.