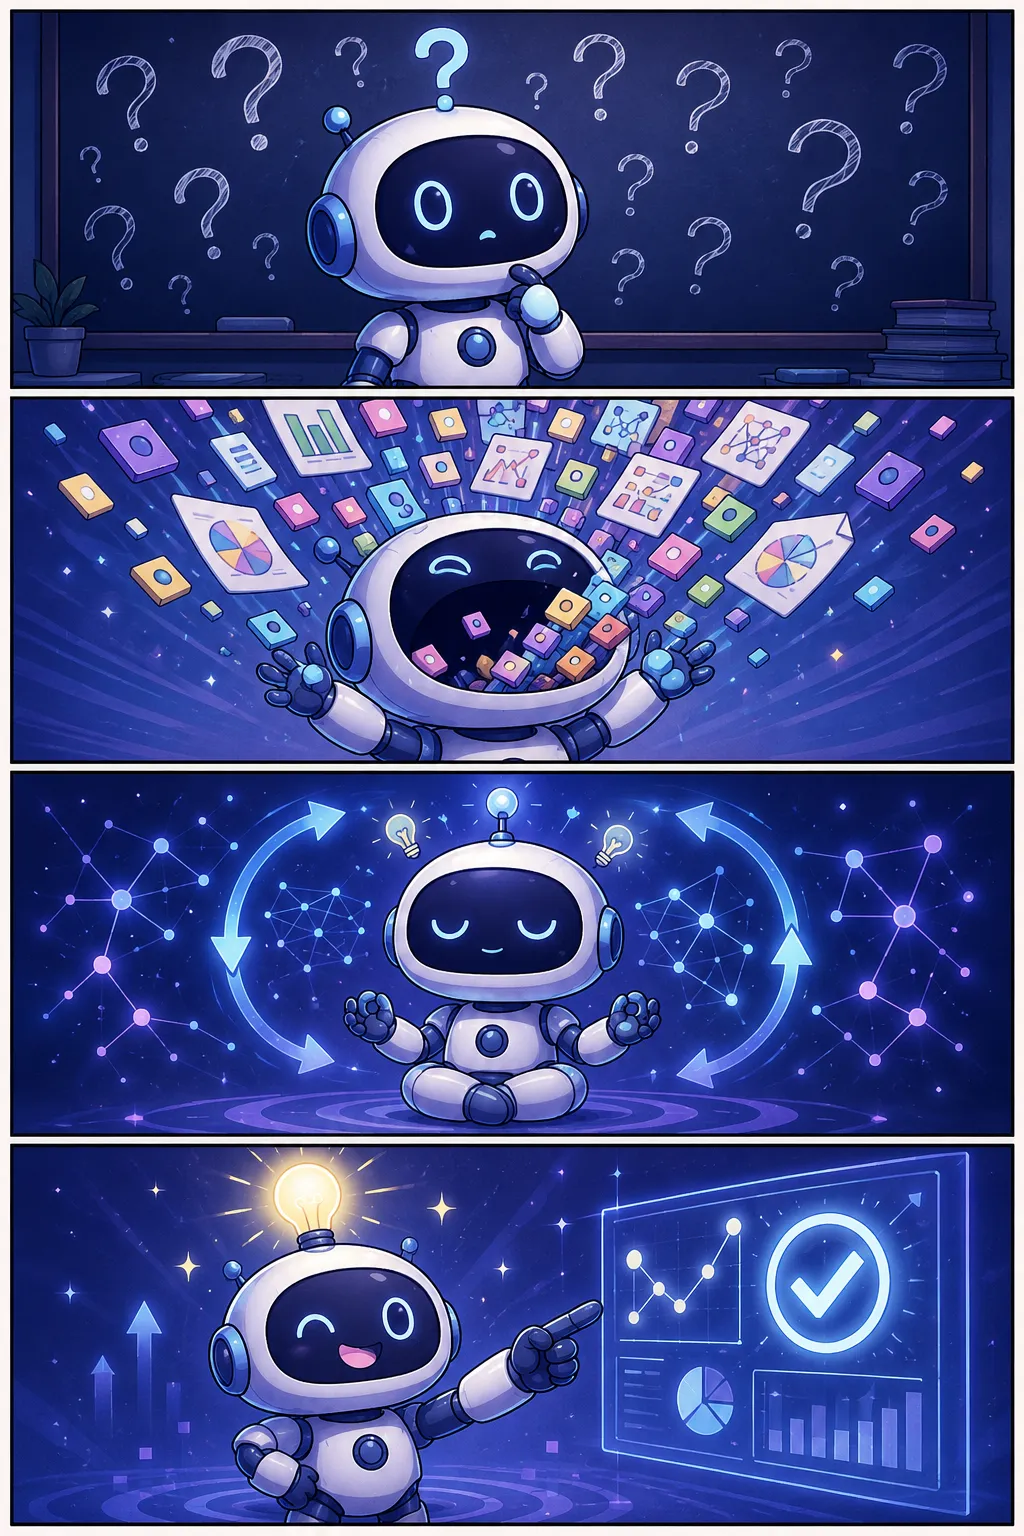
- 11컷: 규칙을 몰라 멍한 로봇
- 22컷: 데이터를 잔뜩 먹기 시작!
- 33컷: 반복할수록 똑똑해지는 중
- 44컷: 스스로 답을 찾아낸 로봇
정의와 배경
머신러닝은 명시적으로 프로그래밍된 규칙 없이 데이터를 분석해 스스로 학습하고 예측·판단하는 알고리즘 및 방법론의 총칭이다. 전통적인 소프트웨어 개발에서는 개발자가 조건과 규칙을 일일이 코드로 작성해야 했지만, 머신러닝에서는 충분한 데이터를 제공하면 모델이 스스로 규칙을 도출한다.
머신러닝이라는 개념은 1950~60년대부터 연구되어 왔으나, 대규모 데이터(빅데이터)의 축적과 연산 능력의 비약적 향상이 이루어진 2010년대 이후 실용화가 급격히 진전되었다. 현재는 딥러닝, 자연어처리, 멀티모달 AI 등 다양한 고급 AI 기술의 공통 기반 방법론으로 자리잡고 있다.
학습 방식의 종류
머신러닝은 학습에 사용하는 데이터의 형태와 목적에 따라 크게 네 가지 방식으로 구분된다. 첫째, 지도학습(Supervised Learning)은 정답(레이블)이 붙은 데이터를 사용해 입력과 출력 간의 관계를 학습하며, 스팸 메일 분류나 이미지 인식에 주로 활용된다. 둘째, 비지도학습(Unsupervised Learning)은 레이블 없이 데이터 내 숨겨진 구조나 군집을 스스로 발견하며, 고객 세분화나 이상 탐지에 쓰인다.
셋째, 반지도학습(Semi-supervised Learning)은 소량의 레이블 데이터와 대량의 비레이블 데이터를 혼합해 학습 효율을 높인다. 넷째, 자기지도학습(Self-supervised Learning)은 데이터 자체에서 학습 신호를 자동으로 생성하는 방식으로, 대규모 언어 모델(LLM) 사전학습에 핵심적으로 활용된다.
왜 중요한가
머신러닝은 복잡하고 방대한 데이터에서 사람이 직접 파악하기 어려운 패턴을 추출할 수 있어, 의료 진단·금융 리스크 분석·공공 서비스 자동화 등 광범위한 분야에서 행정 효율과 의사결정 품질을 높일 수 있다. 특히 정부 디지털 전환 정책 맥락에서는 민원 분류, 이상 징후 탐지, 예산 집행 예측 등 실무 적용 가능성이 크다.
다만 머신러닝 모델의 성능은 학습 데이터의 품질과 양에 크게 좌우되므로, 데이터 편향·개인정보 보호·모델 해석 가능성 등 신뢰성 확보 문제가 함께 고려되어야 한다. 파인튜닝이나 딥러닝 등 고급 기술도 결국 머신러닝의 연장선에 있으므로, 개념적 이해가 AI 정책 수립과 도입 판단의 기초가 된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.