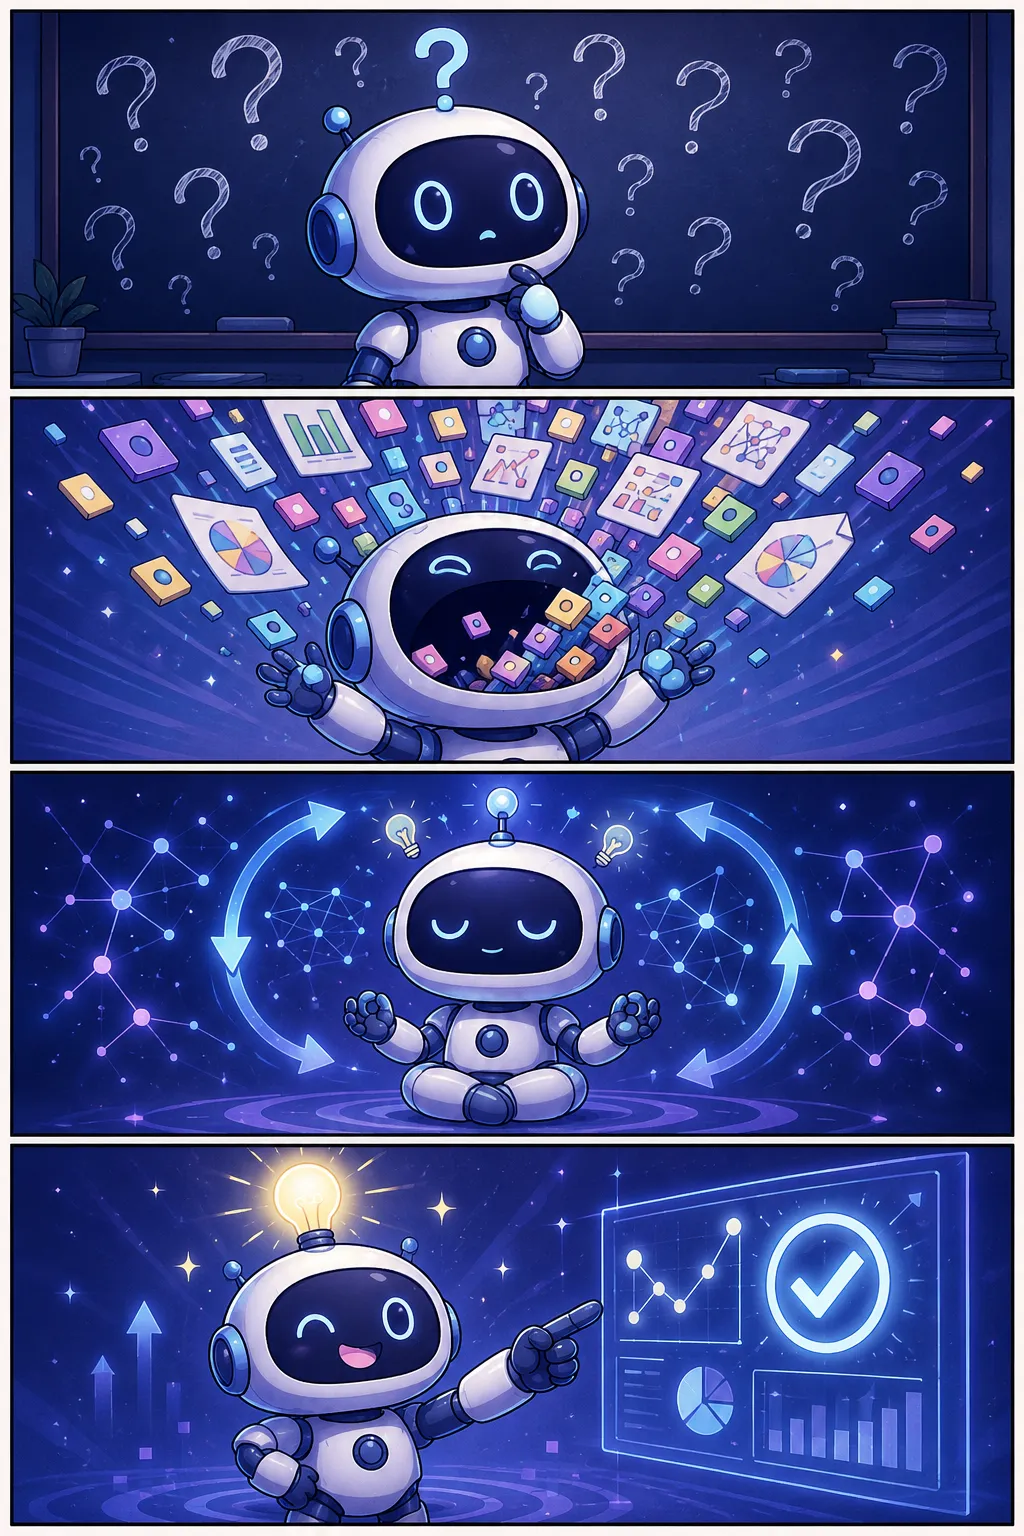
- 11컷: 규칙을 몰라 멍한 로봇
- 22컷: 데이터를 잔뜩 먹기 시작!
- 33컷: 반복할수록 똑똑해지는 중
- 44컷: 스스로 답을 찾아낸 로봇
정의와 배경
머신러닝의 학습 방식은 크게 지도학습(Supervised Learning), 비지도학습(Unsupervised Learning), 강화학습(Reinforcement Learning)으로 구분되어 왔다. 지도학습은 높은 성능을 내지만, 방대한 양의 레이블 데이터를 사람이 직접 구축해야 하는 비용과 시간이 큰 장벽이었다. 자기지도학습은 이 한계를 극복하기 위해 등장한 방법론으로, 데이터 내부의 일부를 의도적으로 가리거나 변형하여 '모델 스스로 정답을 예측하는 과제'를 만들어 냄으로써 레이블 없이도 지도학습에 준하는 효과를 거둔다. 넓은 의미에서는 비지도학습의 한 형태로 보기도 하지만, 자동 생성된 감독 신호를 활용한다는 점에서 전통적 비지도학습과 구별된다.
작동 원리와 주요 방식
자기지도학습의 핵심 원리는 '입력 데이터의 일부를 예측 목표로 삼는 프리텍스트 과제(pretext task) 설계'에 있다. 텍스트 데이터에서는 문장의 일부 단어를 마스킹한 뒤 원래 단어를 예측하게 하는 마스크드 언어 모델링(MLM)이나, 다음 토큰을 순서대로 예측하는 자기회귀(autoregressive) 방식이 대표적이다. 이미지 분야에서는 이미지를 여러 패치로 나눠 순서를 맞추거나, 서로 다른 방식으로 증강된 동일 이미지의 표현이 유사해지도록 학습하는 대조학습(Contrastive Learning)이 활용된다. 모델은 이러한 과제를 풀어가는 과정에서 데이터의 의미적 구조와 문맥을 내재화한 범용 표현을 획득하며, 이후 파인튜닝을 통해 특정 목적 작업에 효율적으로 적용될 수 있다.
왜 중요한가
자기지도학습은 GPT 계열의 대규모 언어모델(LLM), BERT, 멀티모달 AI 모델 등 현재 AI 산업을 이끄는 핵심 기술들의 사전학습(pre-training) 단계에 광범위하게 적용된다. 인터넷상의 수천억 개 텍스트·이미지 데이터를 레이블 비용 없이 학습에 활용할 수 있어 모델의 규모와 성능을 비약적으로 높이는 것이 가능해졌다. 정책·산업 실무 관점에서는, 공공데이터나 행정 문서처럼 레이블 구축이 어려운 비정형 데이터를 AI 학습에 효과적으로 활용할 수 있는 방법론으로서 의미가 크다. 또한 레이블 작업에 드는 인력·비용을 절감해 AI 개발의 경제성을 높이고, 데이터 희소 분야에서도 고성능 모델 개발 가능성을 열어준다는 점에서 AI 대전환 시대의 핵심 기반 기술로 평가된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.