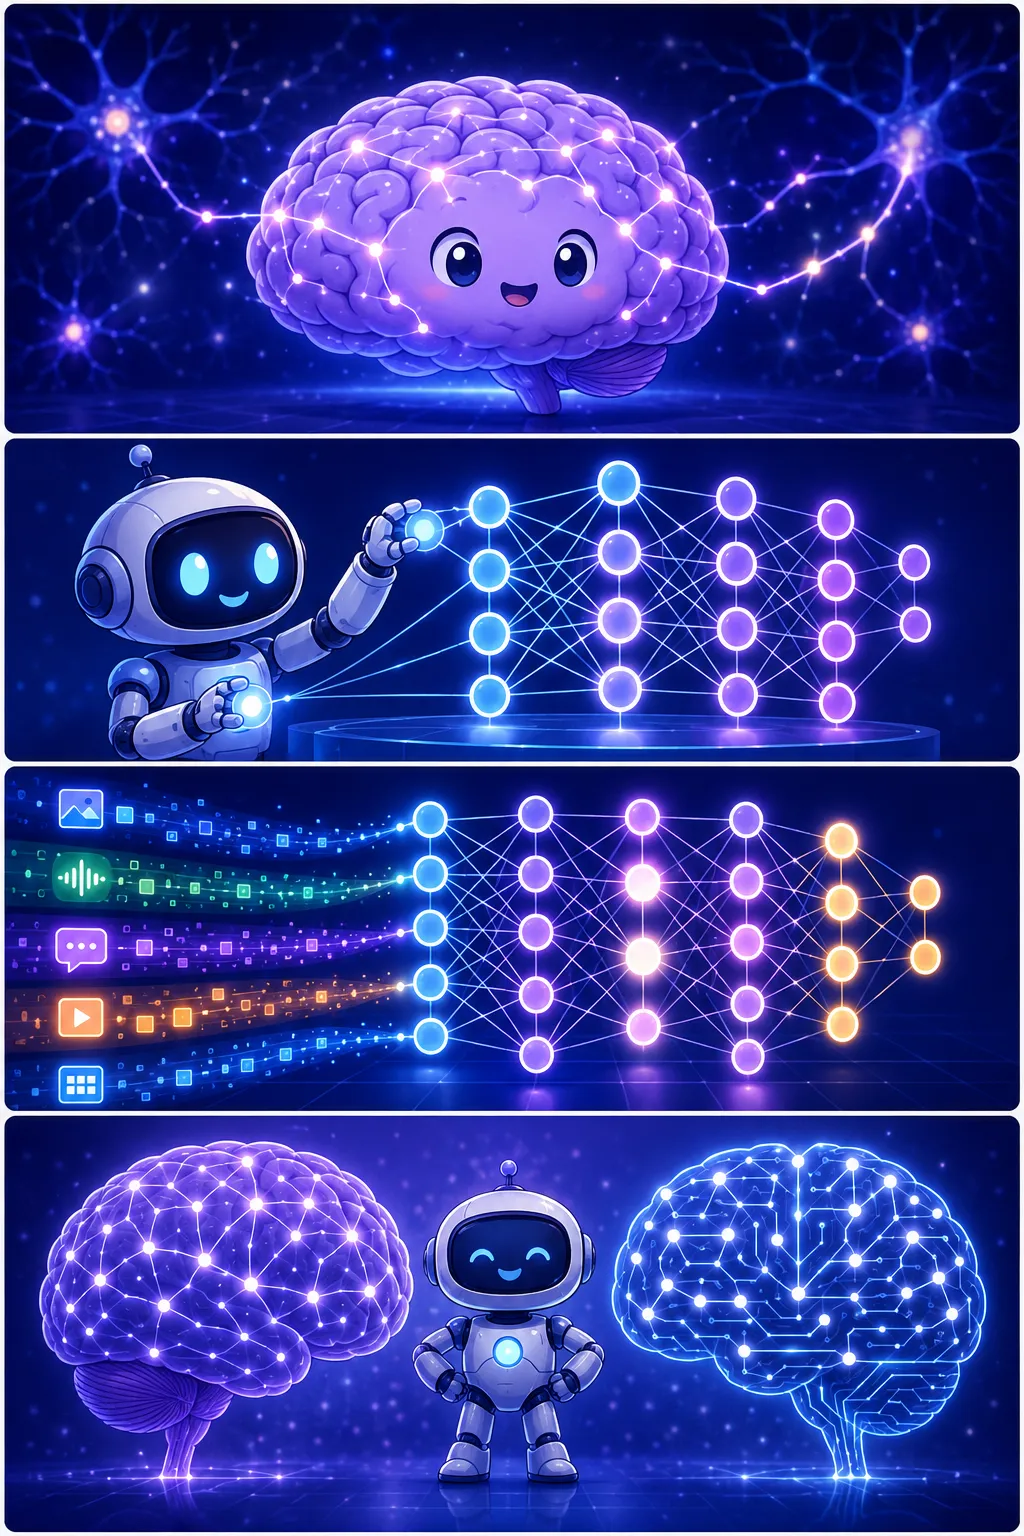
- 1뇌 속 뉴런들이 서로 연결돼 신호를 주고받아요!
- 2AI도 똑같이 노드와 연결선으로 네트워크를 만들어요
- 3데이터를 넣으면 층층이 학습하며 패턴을 찾아내요
- 4결국 인공신경망은 '디지털 뇌'랍니다!
정의와 배경
손실 함수(Loss Function)란 인공신경망이 학습 데이터에 대해 출력한 예측값과 실제 정답값 간의 불일치를 하나의 스칼라(단일 수치)로 표현하는 수학적 함수다. 모델이 얼마나 '틀렸는지'를 측정하는 기준점 역할을 하며, 이 값이 클수록 예측이 부정확함을 의미한다.
머신러닝·딥러닝에서 학습이란 곧 손실 함수의 출력값을 줄여나가는 최적화 과정이다. 인공신경망의 수많은 가중치(파라미터)는 손실 함수가 제공하는 오차 신호를 역전파(Backpropagation) 알고리즘을 통해 전달받아 반복적으로 갱신된다.
주요 종류와 적용 기준
손실 함수는 풀고자 하는 문제 유형에 따라 달리 선택한다. 수치를 예측하는 회귀(Regression) 문제에는 예측값과 정답의 차이를 제곱해 평균하는 평균제곱오차(MSE, Mean Squared Error)가 널리 쓰인다. 이미지 분류처럼 범주를 구분하는 분류(Classification) 문제에는 교차 엔트로피 손실(Cross-Entropy Loss)이 일반적으로 사용된다.
생성형 AI나 대규모 언어 모델(LLM) 학습에는 다음 토큰을 예측하는 과정에서 교차 엔트로피 손실의 변형이 핵심 역할을 하며, 파인튜닝 단계에서도 목적에 맞는 손실 함수를 재설계하거나 조합하는 방식이 흔히 활용된다.
왜 중요한가
손실 함수는 모델이 '무엇을 잘하도록 훈련될 것인가'를 직접 정의하기 때문에, 잘못 설계된 손실 함수는 아무리 많은 학습 데이터와 강력한 연산 자원을 투입해도 원하는 성능을 달성하지 못하게 만든다. 예컨대 불균형 데이터셋에서 단순 정확도를 손실 기준으로 삼으면 소수 범주에 대한 예측이 무시되는 문제가 발생한다.
정책·산업 현장에서 AI 시스템을 도입·평가할 때, 모델 성능 지표(정확도, F1 점수 등)가 어떤 손실 함수 기반으로 최적화되었는지를 파악하는 것은 해당 AI가 실제 목적에 부합하게 학습되었는지를 검증하는 핵심 체크포인트가 된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.