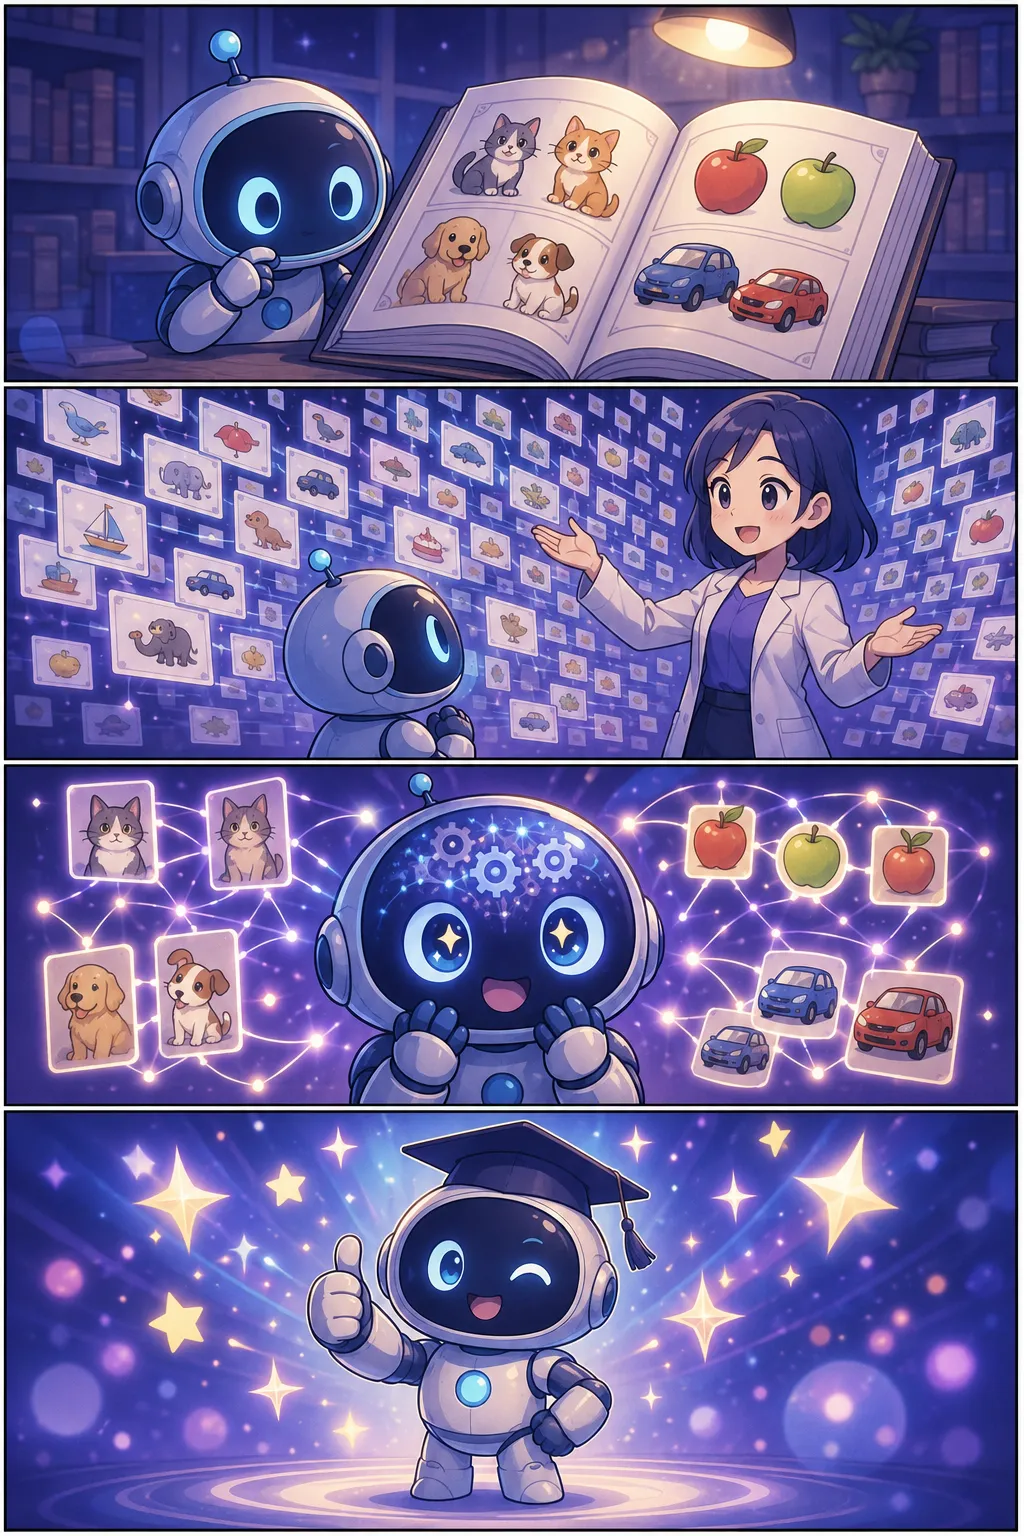
- 1AI야, 넌 어떻게 배우니?
- 2수많은 예시를 보여줘!
- 3반복하면 패턴이 보여!
- 4학습 완료! 나 이제 똑똑해~
정의와 배경
훈련 데이터(Training Data)는 머신러닝·딥러닝 모델을 학습시키기 위해 사용하는 데이터의 집합으로, '학습 데이터'와 동의어로 널리 쓰인다. AI 모델은 인간이 명시적으로 규칙을 입력하는 대신, 대규모 훈련 데이터를 반복적으로 처리하면서 패턴과 통계적 관계를 스스로 추출한다. 인공신경망이 다층 구조로 발전하고 컴퓨팅 성능이 향상됨에 따라, 수억~수천억 건에 달하는 방대한 훈련 데이터를 활용하는 것이 현대 AI 개발의 일반적인 방식이 되었다.
구성과 종류
훈련 데이터는 크게 레이블이 붙은 지도학습용 데이터와 레이블 없이 구조만 존재하는 비지도학습용 데이터로 나뉜다. 지도학습 데이터는 입력값과 정답(레이블)을 쌍으로 구성하며, 이미지 분류·번역·음성 인식 등에 활용된다. 비지도학습 데이터는 인터넷 텍스트, 이미지 등 레이블 없이 수집된 원시 데이터로, 대규모 언어모델(LLM) 사전학습에 주로 사용된다. 멀티모달 AI의 경우 텍스트·이미지·음성 등 서로 다른 형식의 데이터가 복합적으로 훈련 데이터를 구성한다.
데이터의 품질 확보를 위해 수집 후 정제·중복 제거·레이블링 등 전처리 과정이 필수적으로 수반되며, 이 과정에는 상당한 인력과 비용이 투입된다.
왜 중요한가
훈련 데이터는 AI 모델 성능을 결정하는 가장 근본적인 요소 중 하나로, '쓰레기를 넣으면 쓰레기가 나온다(Garbage In, Garbage Out)'는 원칙이 그대로 적용된다. 데이터에 특정 집단에 대한 편향이 포함되어 있으면 모델이 그 편향을 학습하고 재생산하기 때문에, 대표성·다양성·균형성을 갖춘 데이터 구성이 공정한 AI 개발의 전제 조건이 된다. 파인튜닝 단계에서는 사전학습에 사용한 대규모 범용 데이터와 별도로, 목적에 특화된 소규모 고품질 훈련 데이터를 추가로 활용하는 방식이 일반화되어 있다.
정부·공공기관 입장에서는 행정 데이터, 공공 문서, 민원 기록 등을 훈련 데이터로 활용할 경우 개인정보 보호, 저작권, 데이터 주권 등 법적·윤리적 검토가 선행되어야 한다.
정책·실무적 시사점
국내외 AI 정책에서는 고품질 훈련 데이터의 구축·개방을 국가 AI 경쟁력의 핵심 인프라로 간주하며, 공공데이터 개방 확대와 데이터 거버넌스 체계 마련이 주요 과제로 다뤄지고 있다. 실무 담당자는 AI 시스템 도입 시 해당 시스템이 어떤 훈련 데이터로 학습되었는지, 데이터의 출처·편향 여부·갱신 주기를 확인하는 것이 모델 신뢰성 평가의 첫 단계임을 인식할 필요가 있다. 또한 특정 도메인(의료·법률·행정 등)에 특화된 훈련 데이터를 별도로 구축하면 범용 모델 대비 현저히 높은 정확도를 확보할 수 있어, 공공 서비스 AI화에서 전문 데이터셋 투자의 중요성이 강조된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.