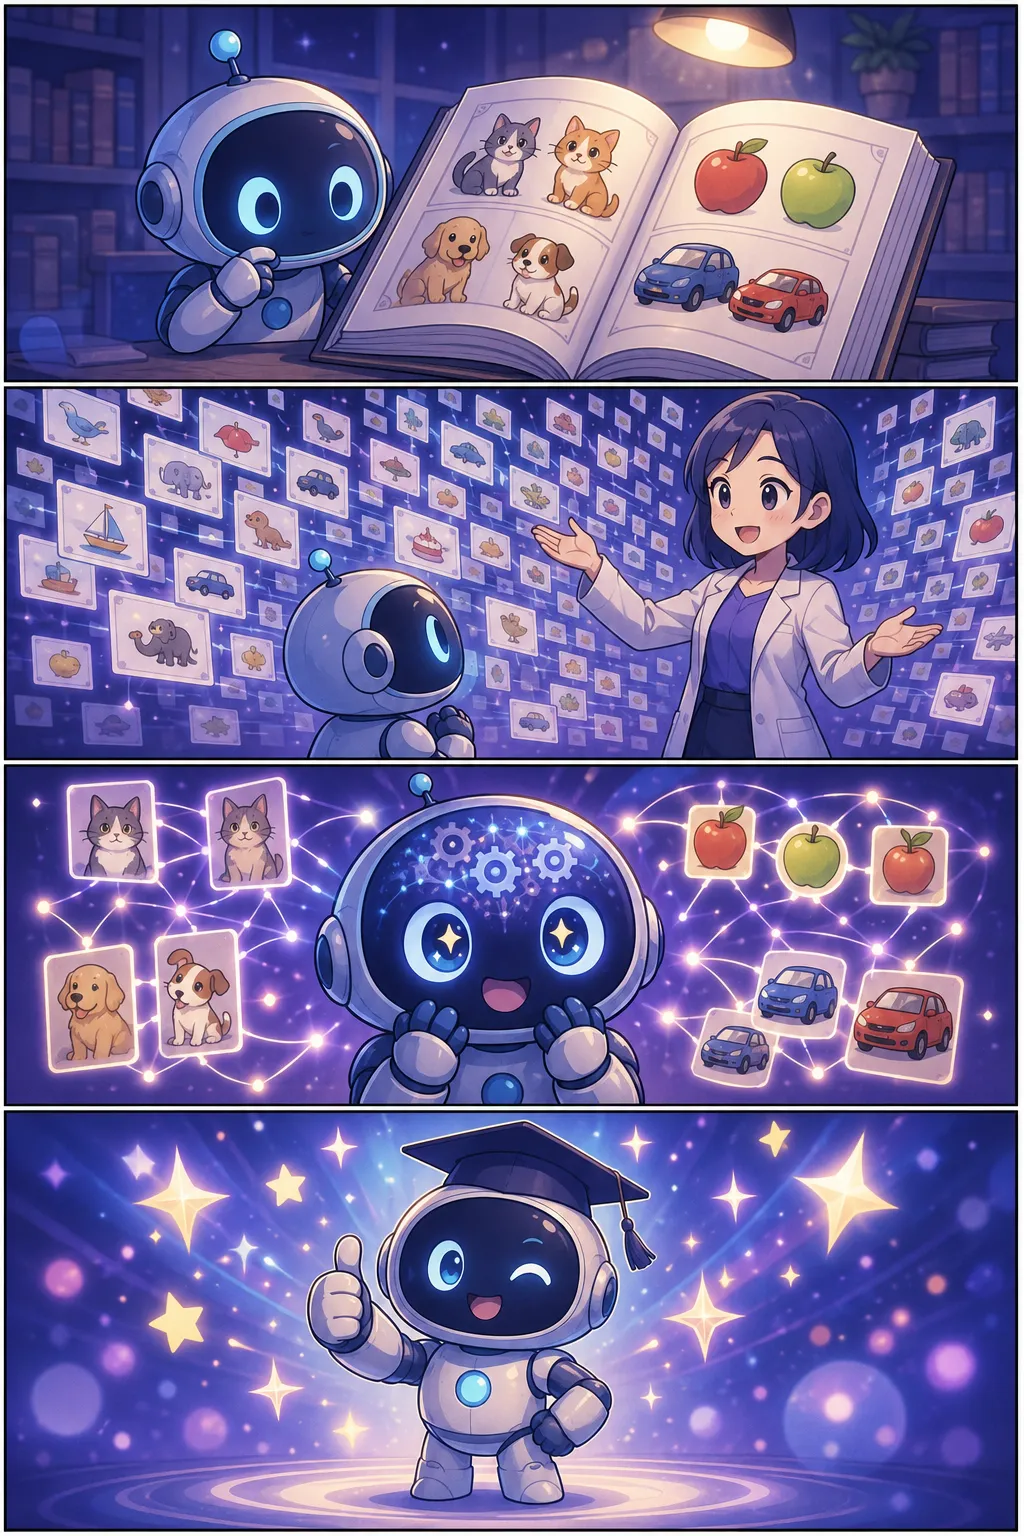
- 1AI야, 넌 어떻게 배우니?
- 2수많은 예시를 보여줘!
- 3반복하면 패턴이 보여!
- 4학습 완료! 나 이제 똑똑해~
정의와 배경
데이터 증강이란 원본 학습 데이터에 다양한 변환을 적용하여 새로운 학습 샘플을 생성하는 기법이다. AI 모델의 성능은 학습 데이터의 양과 질에 크게 좌우되지만, 실무 현장에서는 충분한 데이터를 수집·가공하는 데 막대한 비용과 시간이 소요된다. 데이터 증강은 이 간극을 메우기 위해 등장한 방법론으로, 딥러닝이 본격화된 이후 이미지·음성·텍스트 등 다양한 데이터 유형에 걸쳐 표준적인 학습 준비 절차로 자리 잡았다.
주요 기법과 유형
이미지 데이터의 경우 회전, 반전, 확대·축소, 밝기·색상 조정, 노이즈 추가 등의 변환을 적용해 원본 이미지와 의미는 동일하지만 외형이 다른 샘플을 생성한다. 텍스트 데이터에서는 유사 단어 교체, 문장 순서 변경, 역번역(back-translation) 등의 방법이 활용된다. 음성 데이터에서는 속도 조절, 피치 변환, 배경 소음 합성 등이 대표적이다. 최근에는 생성형 AI(예: GAN, 대형 언어 모델)를 이용해 합성 데이터를 새롭게 만들어내는 방식도 데이터 증강의 한 형태로 포함된다.
왜 중요한가
데이터 증강은 모델이 특정 데이터 패턴에 지나치게 맞춰지는 과적합을 억제하고, 실제 배포 환경의 다양한 입력 변화에 강건하게 대응하도록 일반화 성능을 높인다. 공공 행정·의료·국방 등 민감 분야에서는 개인정보 보호나 데이터 희소성 문제로 충분한 실제 데이터 확보가 어려운 경우가 많아, 데이터 증강과 합성 데이터 생성이 현실적인 대안으로 주목받고 있다. 파인튜닝이나 멀티모달 AI 학습 시에도 증강된 데이터를 활용하면 상대적으로 적은 원본 데이터로도 안정적인 모델 성능을 기대할 수 있다.
정책·실무 적용 시 유의사항
데이터 증강이 효과를 발휘하려면 변환 방법이 해당 도메인의 실제 조건을 반영해야 한다. 예컨대 의료 영상에서 비현실적인 변환을 적용하면 오히려 모델이 잘못된 패턴을 학습할 수 있다. 또한 합성 데이터를 활용하는 경우 데이터의 출처와 품질 관리 기준을 명확히 하고, AI 학습 데이터 관련 가이드라인에 따라 투명하게 관리하는 것이 공공 신뢰 확보를 위해 중요하다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.