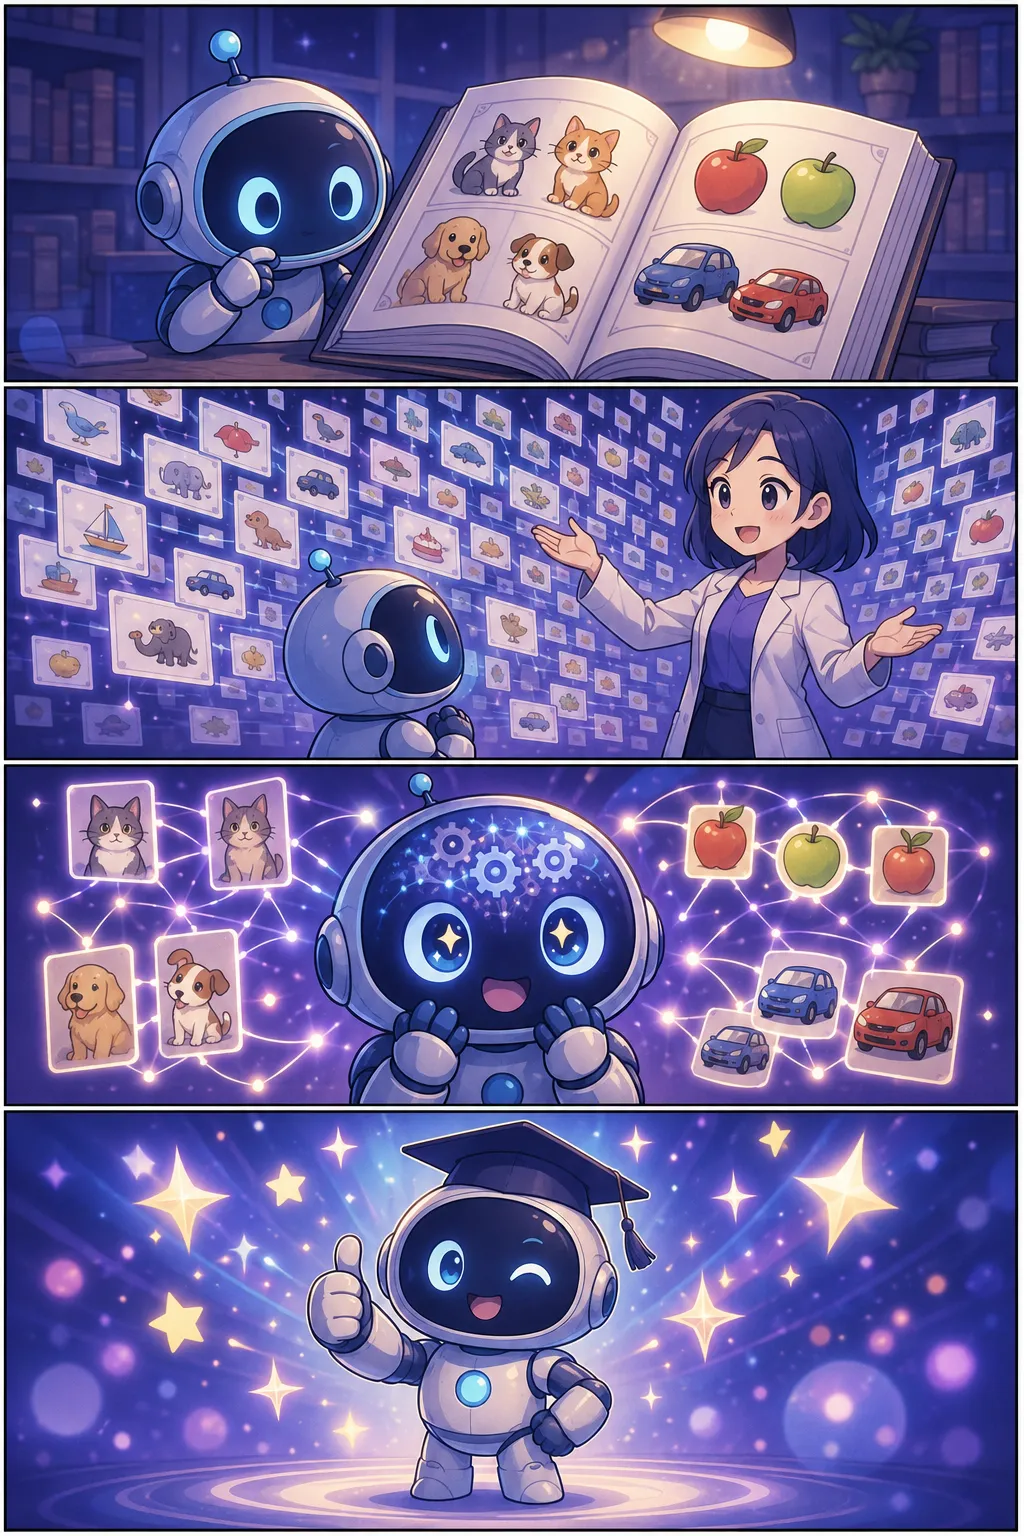
- 1AI야, 넌 어떻게 배우니?
- 2수많은 예시를 보여줘!
- 3반복하면 패턴이 보여!
- 4학습 완료! 나 이제 똑똑해~
정의와 배경
AI 저작권 문제는 크게 두 가지 국면으로 나뉜다. 첫째는 '학습 데이터 저작권' 문제로, 대규모 언어 모델·이미지 생성 모델 등을 개발할 때 인터넷상의 텍스트·이미지·음악·코드 등 저작물을 저작권자의 허락 없이 수집·학습에 활용하는 행위가 저작권 침해에 해당하는지에 관한 쟁점이다. 둘째는 'AI 생성물 저작권' 문제로, AI가 산출한 텍스트·이미지·음악 등의 창작물에 저작권이 인정되는지, 인정된다면 그 권리가 개발사·이용자·AI 모델 자체 중 누구에게 귀속되는지에 관한 쟁점이다. 생성형 AI 기술이 급속히 확산되면서 전통적인 저작권 체계의 공백이 부각되고 있다.
주요 쟁점과 각국의 논의
학습 데이터 측면에서는 저작권법상 '공정 이용(Fair Use)' 또는 '텍스트·데이터 마이닝(TDM)' 예외 조항이 AI 학습에도 적용될 수 있는지가 핵심 쟁점이다. 미국에서는 다수의 소송이 진행 중이며, 유럽연합은 DSM 저작권 지침을 통해 상업적 목적의 TDM에는 저작권자의 거부 의사 표시(opt-out)를 존중하도록 규정하고 있다. 일본은 비영리·영리를 불문하고 학습 목적의 데이터 이용을 폭넓게 허용하는 해석을 취하면서도 세부 논의가 이어지고 있다. 한국은 저작권법상 명시적 예외 규정이 미비하여 법 개정 및 가이드라인 마련이 정책 과제로 부상하고 있다.
AI 생성물의 저작권 귀속 문제와 관련하여, 주요국의 사법·행정 기관은 대체로 '인간의 창작적 기여'가 없는 순수 AI 생성물에는 저작권이 성립하지 않는다는 입장을 취하고 있다. 그러나 인간이 프롬프트를 설계하거나 결과물을 선별·편집하는 경우 창작적 기여를 인정할 수 있는지에 대해서는 국가별로 판단이 엇갈린다.
정책·실무적 시사점
정부 및 공공기관이 AI 서비스를 도입하거나 AI를 활용한 콘텐츠를 생산할 경우, 학습 데이터의 적법성 여부와 AI 산출물의 저작권 지위를 명확히 확인해야 하는 법적 리스크가 존재한다. 특히 공공데이터를 AI 학습에 개방하거나 정부 발간 콘텐츠를 AI로 제작하는 사업에서는 저작권 침해 소지와 저작권 귀속 주체를 사전에 검토해야 한다. 국내에서는 문화체육관광부와 한국저작권위원회를 중심으로 AI 저작권 가이드라인 수립 논의가 진행되고 있으며, 향후 저작권법 개정을 통해 TDM 예외 조항 및 AI 생성물 보호 규정을 신설하는 방향이 검토되고 있다. 실무자는 사용하는 AI 도구의 학습 데이터 출처와 이용약관을 확인하고, AI 생성 결과물을 공식 문서에 활용할 때에는 인간의 검토·편집 기여를 명확히 기록해 두는 것이 권고된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.