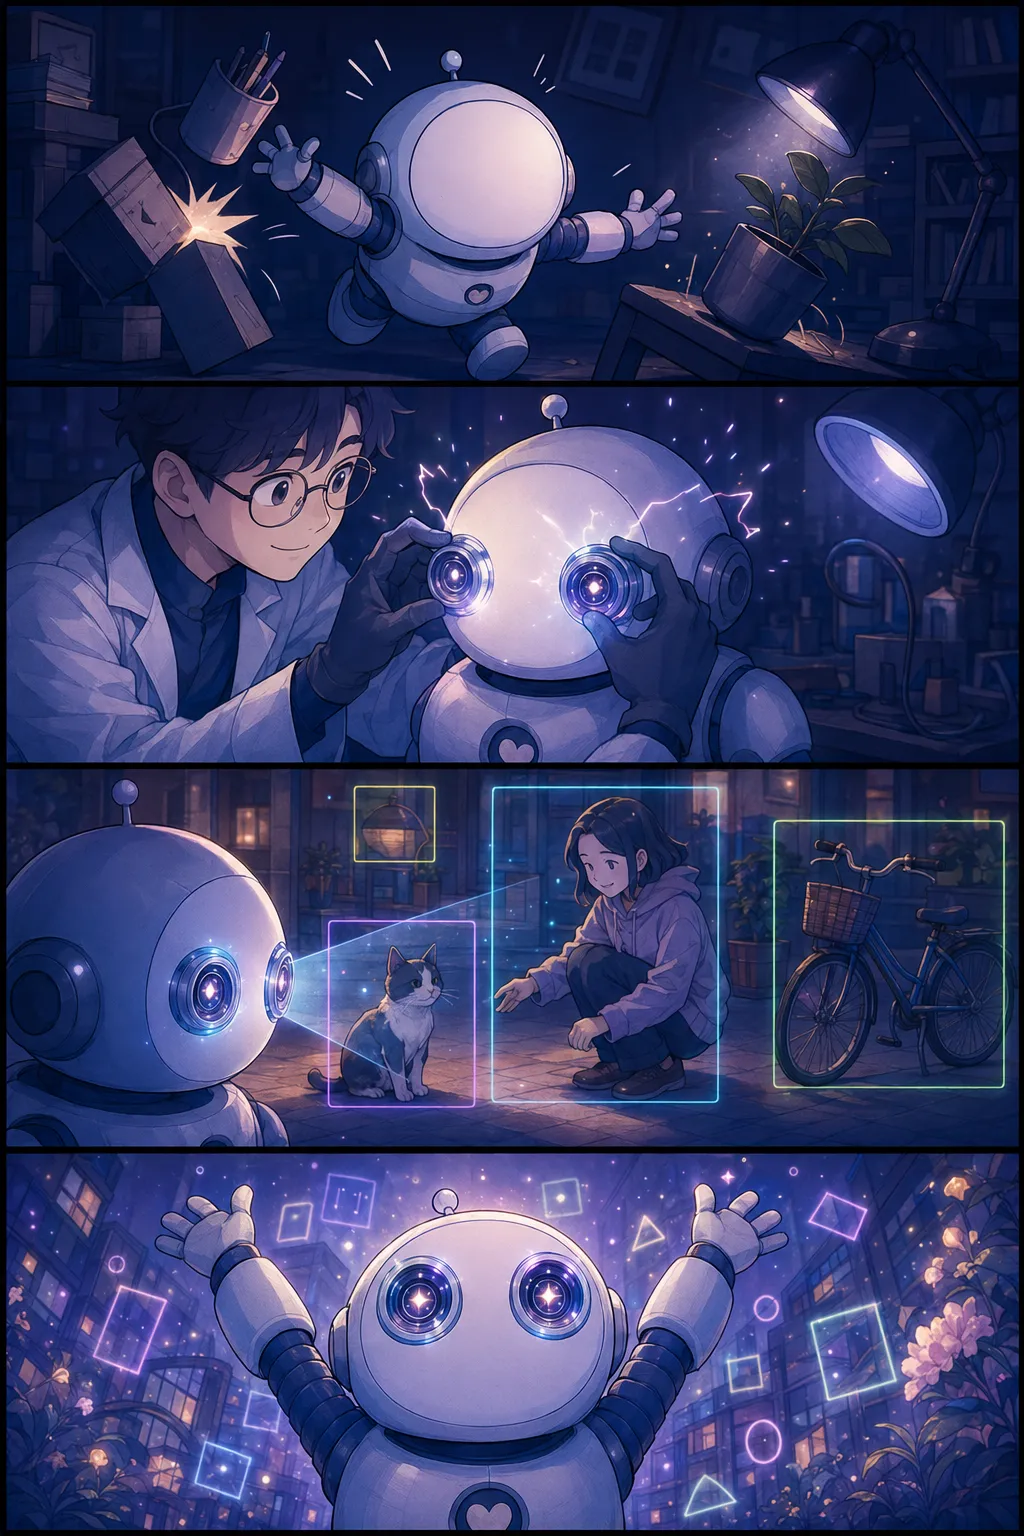
- 11컷: 눈 없이 태어난 로봇 😶
- 22컷: 카메라 눈을 달아줬더니!
- 33컷: 고양이? 사람? 뭐든 척척!
- 44컷: 세상이 보여요, 선생님! 🤖👁️
정의와 배경
객체 탐지는 컴퓨터 비전의 핵심 세부 과제 중 하나로, 입력된 이미지 또는 동영상 프레임에서 사람·차량·동물·제품 등 특정 객체가 어디에 있고 무엇인지를 자동으로 판별하는 기술이다. 이미지 전체에 단일 레이블을 부여하는 이미지 분류(Image Classification)와 달리, 객체 탐지는 한 화면 안에 존재하는 다수의 객체를 각각 구분하여 위치 좌표(바운딩 박스)와 클래스 정보를 함께 출력한다.
초기에는 전통적인 영상처리 기법과 수작업으로 설계된 특징값(feature)을 활용하였으나, 딥러닝이 보편화된 이후 합성곱 신경망(CNN) 기반 모델이 주류로 자리잡으며 정확도와 처리 속도가 획기적으로 개선되었다.
작동 원리와 주요 방식
객체 탐지 모델은 크게 '2단계(Two-stage)' 방식과 '1단계(One-stage)' 방식으로 나뉜다. 2단계 방식은 먼저 객체가 있을 법한 후보 영역을 추출한 뒤 각 영역을 분류하는 구조로, 정확도가 높은 반면 처리 속도가 상대적으로 느리다. 반면 1단계 방식은 후보 영역 추출과 분류를 단일 신경망에서 동시에 수행하여 실시간 탐지에 유리하다.
모델 학습에는 객체의 위치(바운딩 박스 좌표)와 종류(클래스 레이블)가 모두 표기된 주석(annotation) 데이터가 필요하며, 이를 학습 데이터로 삼아 신경망이 패턴을 익힌다. 탐지 성능은 일반적으로 정밀도(Precision)·재현율(Recall)·mAP(mean Average Precision) 등의 지표로 평가한다.
주요 활용 분야
객체 탐지는 자율주행 차량의 보행자·신호등·장애물 인식, 제조 현장의 불량품 검수, 의료 영상에서의 병변 위치 파악, 교통·치안 CCTV 분석, 스마트물류의 상품 식별 등 광범위한 분야에 활용된다. 공공 부문에서는 도시 안전망 강화, 재난 현장 모니터링, 불법 주정차 단속 등에 도입 사례가 늘고 있다.
멀티모달 AI와 결합하면 탐지된 객체에 대한 언어적 설명이나 음성 안내까지 함께 제공할 수 있어 활용 범위가 더욱 확장되는 추세다.
정책·실무적 고려사항
객체 탐지 시스템을 공공·행정 목적으로 도입할 때는 개인정보 보호 문제가 핵심 쟁점으로 부상한다. 특히 얼굴·번호판 등 개인 식별 정보가 포함된 경우 관련 법령 및 영향평가 절차를 준수해야 한다. 또한 모델의 탐지 정확도는 학습 데이터의 다양성과 품질에 크게 좌우되므로, 한국 환경에 특화된 데이터 구축과 지속적인 모델 갱신 체계 마련이 실무적으로 중요하다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.