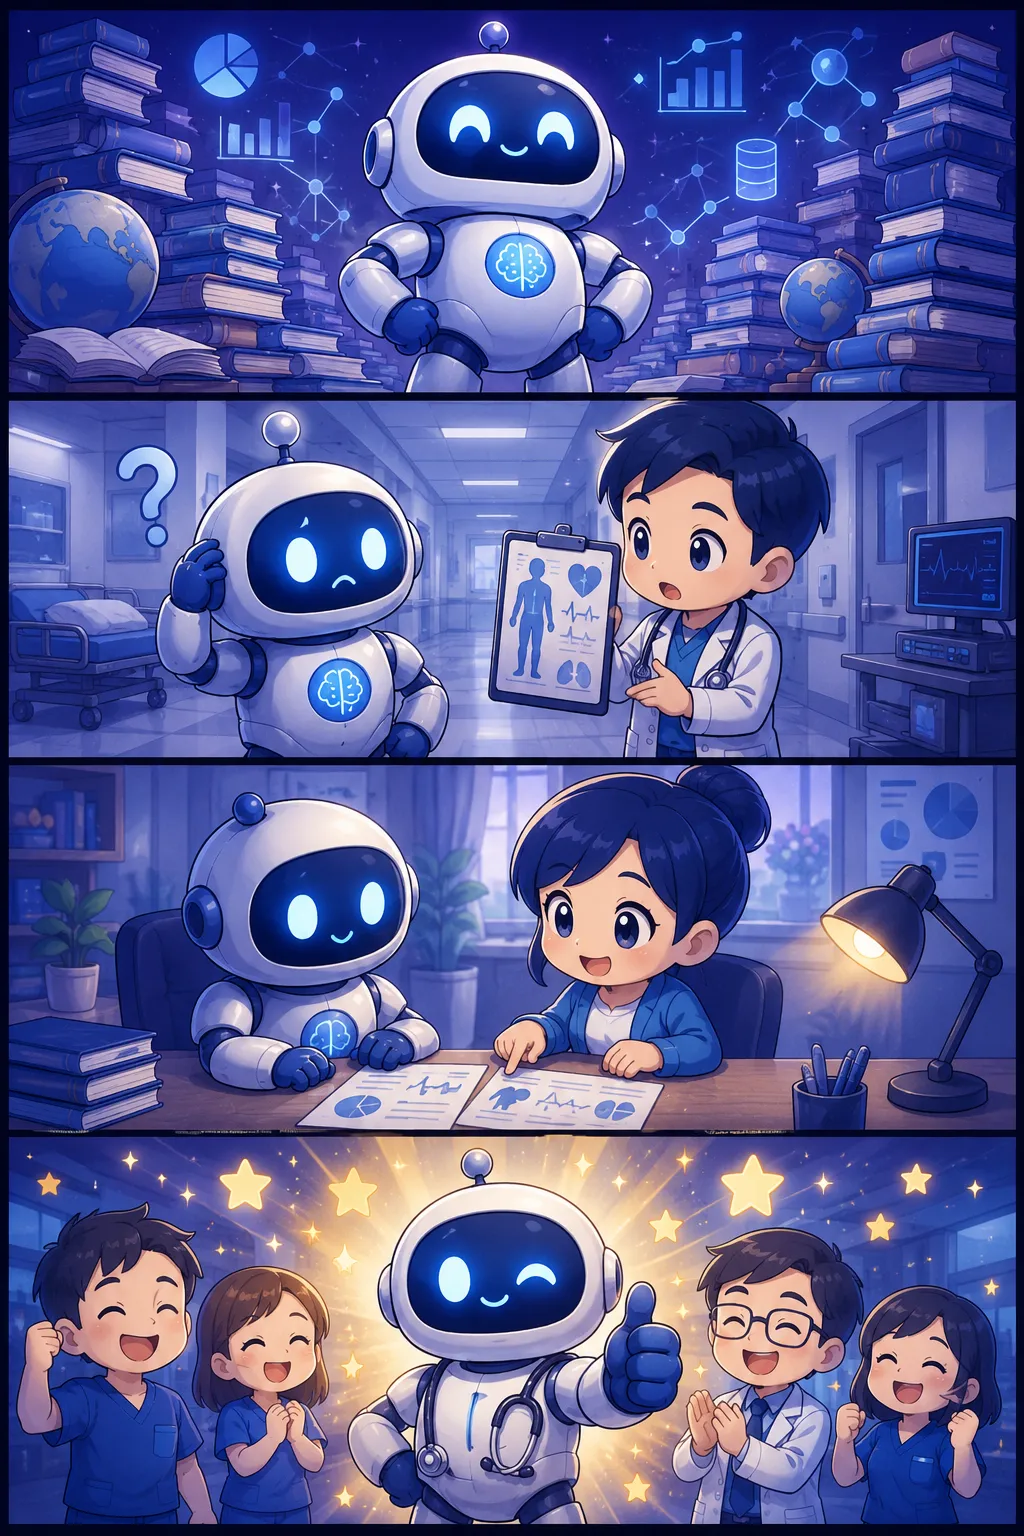
- 1거대 AI, 모든 걸 배웠어요!
- 2근데 우리 병원 말투는 달라요…
- 3조금만 더 가르쳐 드릴게요!
- 4완벽한 의료 AI 탄생✨
정의와 배경
파인튜닝은 GPT, LLaMA 등 파운데이션 모델이 범용 텍스트로 습득한 언어 능력을 기반으로, 특정 업무나 도메인에 특화된 소량의 데이터를 추가 학습시켜 모델을 재조정하는 기법이다. 파운데이션 모델이 등장하기 이전에는 각 태스크마다 별도의 모델을 처음부터 학습해야 했으나, 사전학습(Pre-training) 패러다임이 정착하면서 파인튜닝이 AI 실용화의 표준 경로로 부상하였다. 전이학습(Transfer Learning)의 일종으로, 모델이 이미 학습한 광범위한 표현 능력을 목표 분야에 '전이'한다는 개념에서 출발한다.
작동 원리와 주요 방식
기본적인 파인튜닝은 사전학습 완료된 모델의 가중치(weight)를 초기값으로 삼아, 특정 도메인 데이터셋으로 추가 역전파(backpropagation) 학습을 수행하는 방식이다. 전체 가중치를 갱신하는 '풀 파인튜닝'은 높은 성능을 기대할 수 있으나 GPU 메모리와 비용이 많이 들기 때문에, 일부 파라미터만 조정하는 경량화 기법이 널리 쓰인다. 대표적인 경량 기법으로는 LoRA(Low-Rank Adaptation), QLoRA 등이 있으며, 이를 통해 상대적으로 적은 연산 자원으로도 준수한 전문화 성능을 달성할 수 있다. 또한 사람의 선호도를 반영해 모델 출력을 교정하는 RLHF(인간 피드백 강화학습)도 파인튜닝의 한 형태로 분류된다.
왜 중요한가
공공기관이나 기업이 범용 AI 모델을 그대로 사용할 경우, 전문 법령·행정 절차·산업 용어 등 도메인 특수성을 충분히 반영하기 어렵다. 파인튜닝을 통해 의료·법률·국방·금융 등 각 분야에 최적화된 전문 모델을 비교적 낮은 비용으로 구축할 수 있어, 정부 주도 AI 도입 사업에서도 핵심 기술 요소로 다루어진다. 국내 AIDC 메가프로젝트(8.4GW 규모) 맥락에서도 데이터센터 인프라 구축과 함께 공공·민간 파인튜닝 수요를 뒷받침하는 GPU 클러스터 확보가 중요한 정책 과제로 연결된다. 모델을 외부에 공개하지 않고 온프레미스 환경에서 파인튜닝할 경우 데이터 보안·주권 측면에서도 유리하여, 민감 정보를 다루는 공공 분야에서 특히 주목받고 있다.
실무적 고려사항
파인튜닝의 효과는 학습 데이터의 품질과 양, 모델 구조, 하이퍼파라미터 설정에 따라 크게 달라지므로 데이터 전처리와 라벨링 체계가 사전에 갖추어져야 한다. 과도한 파인튜닝은 모델이 특정 데이터에만 과적합(overfitting)되거나, 기존에 보유하던 범용 능력을 잃는 '치명적 망각(catastrophic forgetting)' 현상을 일으킬 수 있어 주의가 필요하다. 정부·공공기관 실무자는 파인튜닝 수행 시 학습 데이터의 저작권·개인정보 준수 여부와 함께, 결과 모델의 편향성 및 안전성 평가 절차를 병행하도록 요구된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.