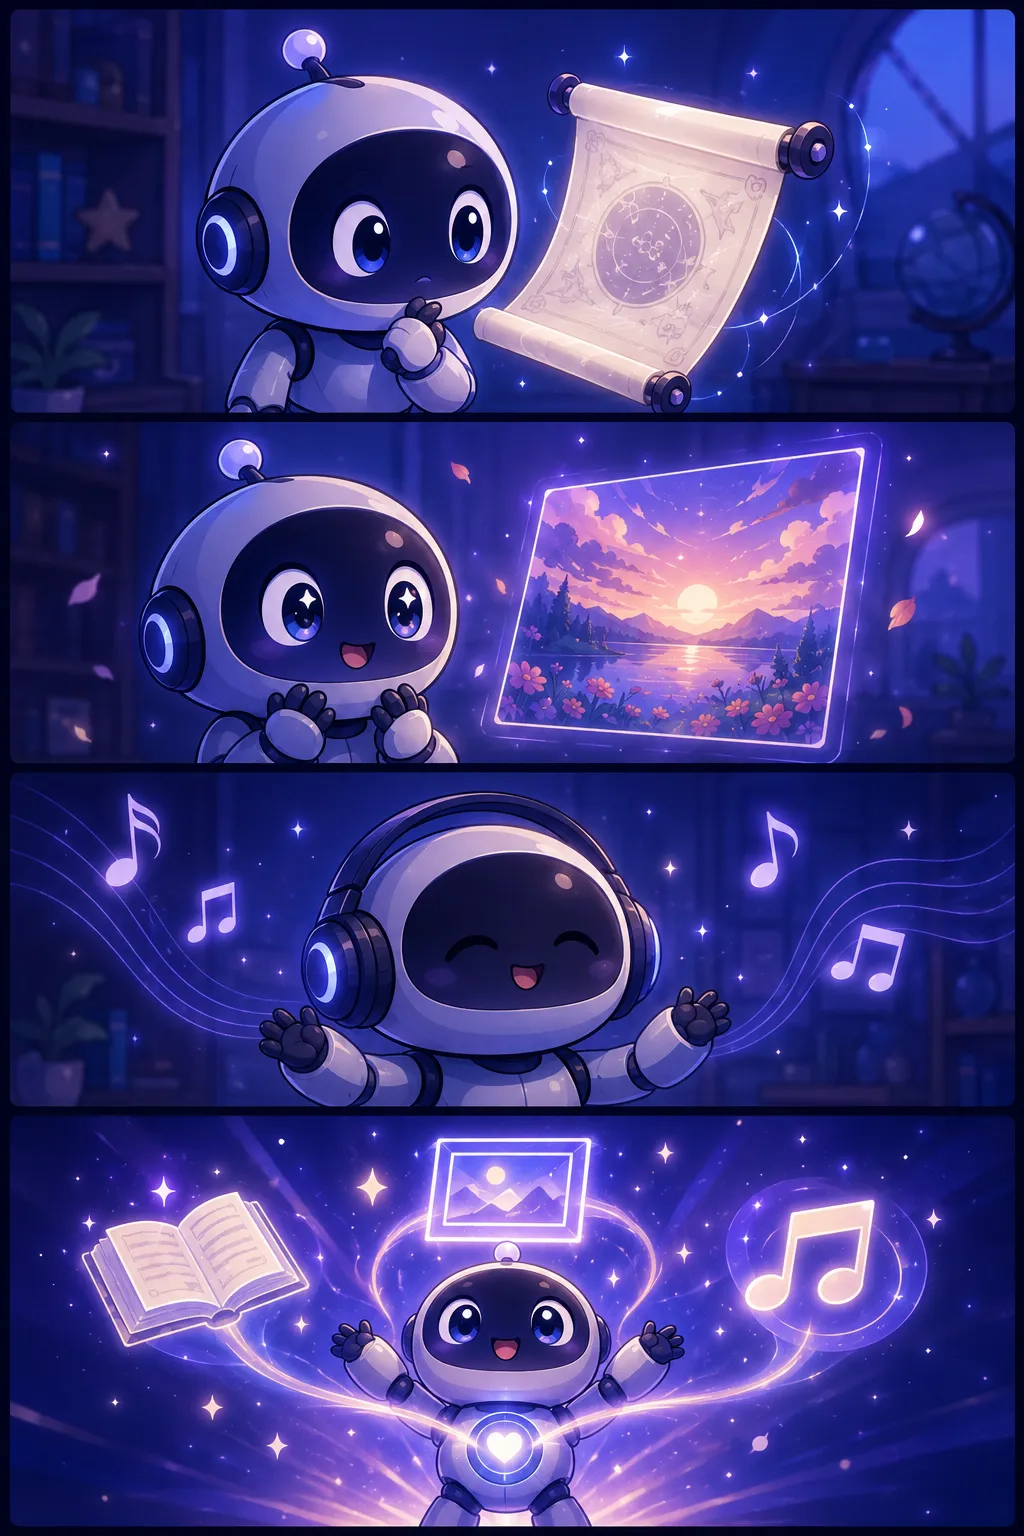
- 11컷: 로봇이 글자를 읽으며 '음…'
- 22컷: 로봇이 그림을 보며 '오!'
- 33컷: 로봇이 음악을 들으며 '흠흥~'
- 44컷: 모든 감각을 합쳐 '다 알아요!' 만능 로봇 완성!
정의와 배경
멀티모달 AI(Multimodal AI)란 텍스트, 이미지, 음성, 영상, 표 등 복수의 데이터 형식을 하나의 모델 안에서 통합적으로 처리하는 인공지능을 말한다. 인간이 시각·청각·언어를 동시에 활용하여 세상을 이해하는 방식을 AI로 구현하려는 시도에서 출발했다.
초기 AI 연구는 텍스트만 다루는 자연어처리(NLP) 또는 이미지만 다루는 컴퓨터비전처럼 단일 모달리티에 집중했다. 그러나 딥러닝 기반 대규모 사전학습 모델이 발전하고 방대한 학습 데이터 확보가 가능해지면서, 여러 모달리티를 하나의 모델로 처리하는 멀티모달 접근이 실용화 단계에 접어들었다.
작동 원리와 주요 유형
멀티모달 AI는 각 모달리티별로 특화된 인코더(예: 이미지 인코더, 텍스트 인코더)가 입력 데이터를 공통 표현 공간(embedding space)으로 변환한 뒤, 이를 통합하여 추론하거나 출력을 생성하는 구조를 주로 취한다. 이 과정에서 어텐션 메커니즘이 서로 다른 모달리티 간의 관계를 학습하는 데 핵심적인 역할을 한다.
대표적인 유형으로는 ▲텍스트와 이미지를 함께 이해하거나 생성하는 비전-언어 모델(VLM), ▲음성을 텍스트로 변환하거나 텍스트로부터 음성을 합성하는 음성-텍스트 모델, ▲텍스트 설명으로 이미지를 생성하는 텍스트-이미지 모델 등이 있다. 한 모달리티의 정보를 다른 모달리티로 연결하는 능력을 크로스모달(cross-modal) 이해라고도 부른다.
왜 중요한가
현실 세계의 정보는 텍스트 단독이 아니라 이미지, 소리, 문서, 표 등 다양한 형식이 혼합된 형태로 존재한다. 멀티모달 AI는 이러한 복합 정보를 단일 시스템으로 처리함으로써 의료 영상 판독·문서 자동화·자율주행·공공 민원 처리 등 폭넓은 분야에서 실질적인 업무 자동화를 가능하게 한다.
정책·산업 실무 관점에서는 공문서 이미지, 현장 사진, 음성 회의록 등 이종(異種) 데이터를 통합 분석하는 행정 지능화 시스템 구축의 핵심 기반 기술로 주목받고 있다. 단일모달 모델 대비 더 많은 연산 자원과 다양한 형식의 대규모 학습 데이터가 필요하다는 점은 도입 시 고려해야 할 현실적 제약이다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.