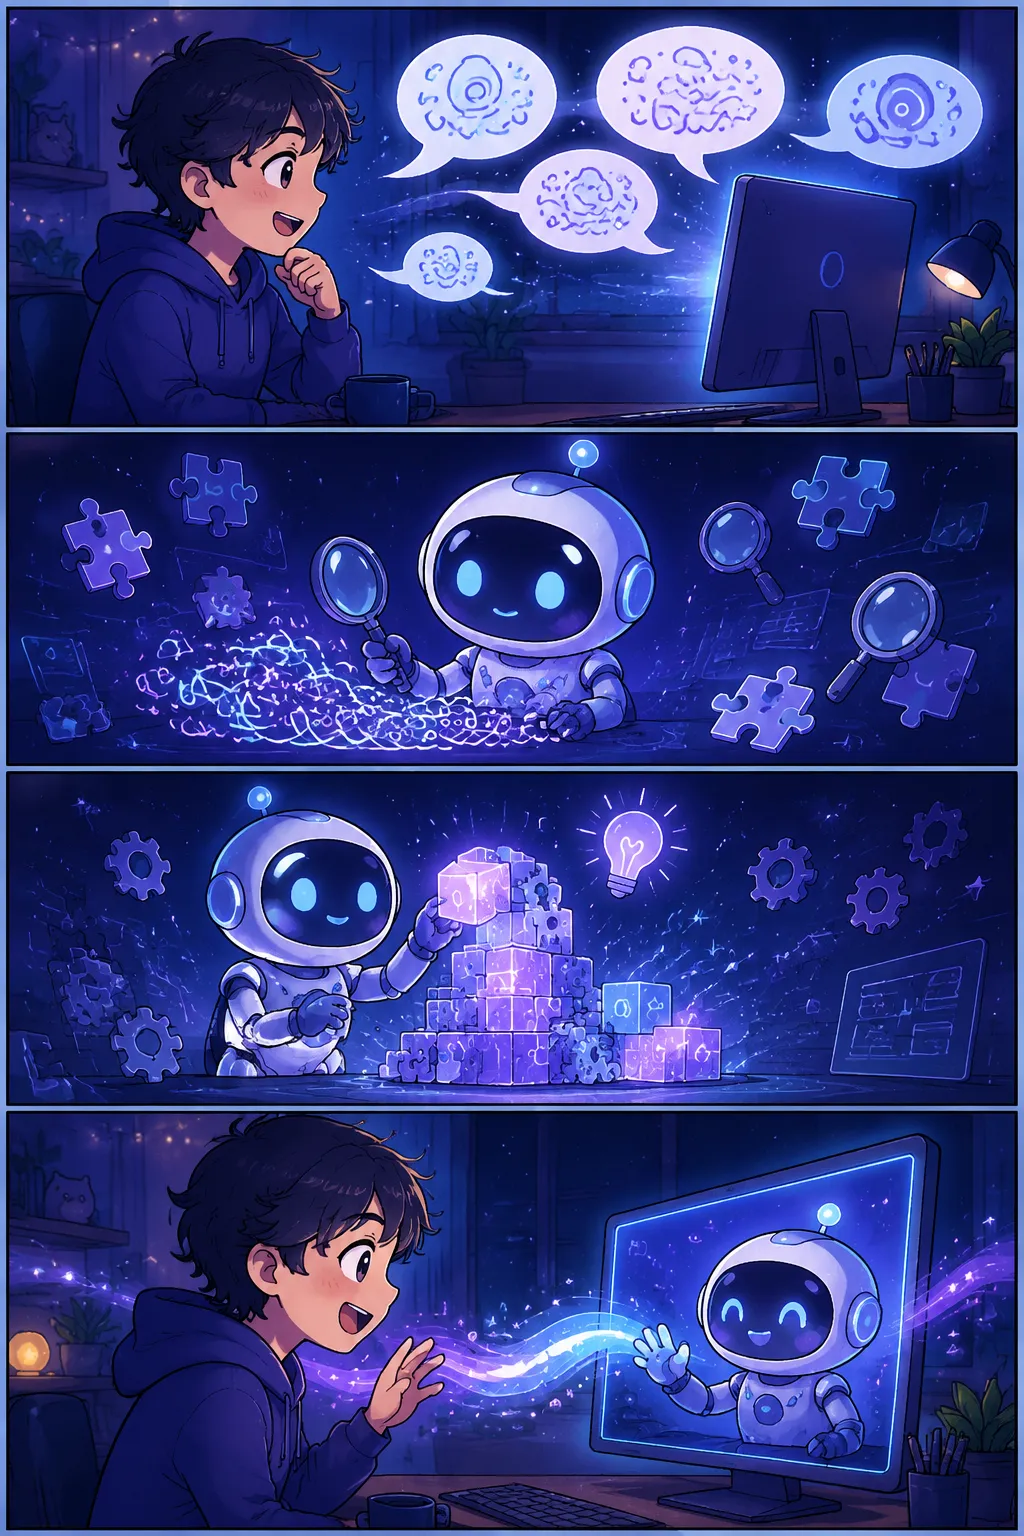
- 1사람이 컴퓨터에게 말을 건넨다
- 2AI가 말의 뜻을 분석하고 이해한다
- 3AI가 적절한 답변을 만들어낸다
- 4사람과 AI가 자연스럽게 대화한다
정의와 배경
자연어처리란 사람이 일상적으로 사용하는 언어, 즉 '자연어'를 컴퓨터가 처리할 수 있도록 하는 기술 및 연구 분야를 통칭한다. 초기에는 문법 규칙을 사람이 직접 정의하는 규칙 기반 방식이 주류였으나, 머신러닝과 딥러닝이 발전하면서 대규모 텍스트 데이터로부터 언어 패턴을 자동으로 학습하는 방식으로 전환되었다. 특히 트랜스포머(Transformer) 구조가 도입된 이후 언어 이해와 생성 성능이 비약적으로 향상되었으며, 이를 기반으로 한 GPT, BERT 등의 사전학습 모델이 NLP 연구와 산업 응용의 표준으로 자리 잡았다.
주요 기술과 응용 분야
자연어처리는 단일 기술이 아니라 여러 세부 기술의 집합이다. 대표적으로 텍스트에서 인물·기관·지명 등 의미 있는 단위를 추출하는 개체명 인식(NER), 글의 긍·부정 감정을 판별하는 감성 분석, 언어 간 의미를 변환하는 기계 번역, 긴 문서를 핵심 내용으로 압축하는 요약 생성, 질문에 적합한 답변을 찾아내는 질의응답(QA) 등이 있다. 이러한 기술들은 공공 민원 챗봇, 행정 문서 자동 분류, 법령 검색, 여론 모니터링 등 정부·공공 부문에서도 실질적으로 활용된다.
딥러닝·LLM과의 관계
NLP는 딥러닝의 발전과 긴밀하게 연결되어 있으며, 인공신경망을 다층으로 쌓은 구조를 통해 단어 간 문맥적 관계를 학습한다. 최근에는 방대한 학습 데이터로 사전학습된 대규모 언어 모델(LLM)에 파인튜닝을 적용하여 특정 업무에 최적화하는 방식이 보편화되었다. 또한 멀티모달 AI의 부상으로 NLP는 텍스트 처리를 넘어 이미지·음성과 결합된 복합적 언어 이해로 확장되고 있다.
정책·실무적 의의
정부 및 공공기관 입장에서 NLP는 대민 서비스 자동화, 대규모 문서의 신속한 분석, 다국어 행정 서비스 제공 등에 직접적으로 기여할 수 있는 핵심 기반 기술이다. 다만 NLP 모델은 학습 데이터의 편향을 그대로 반영할 수 있으며, 특히 한국어와 같이 교착어 특성을 가진 언어는 영어 중심 모델의 성능이 저하될 수 있어 별도의 한국어 특화 모델 개발 및 데이터 구축이 필요하다. 정책 입안자는 NLP 도입 시 모델의 언어 처리 정확도, 개인정보 보호, 결과의 설명 가능성 등을 함께 고려해야 한다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.