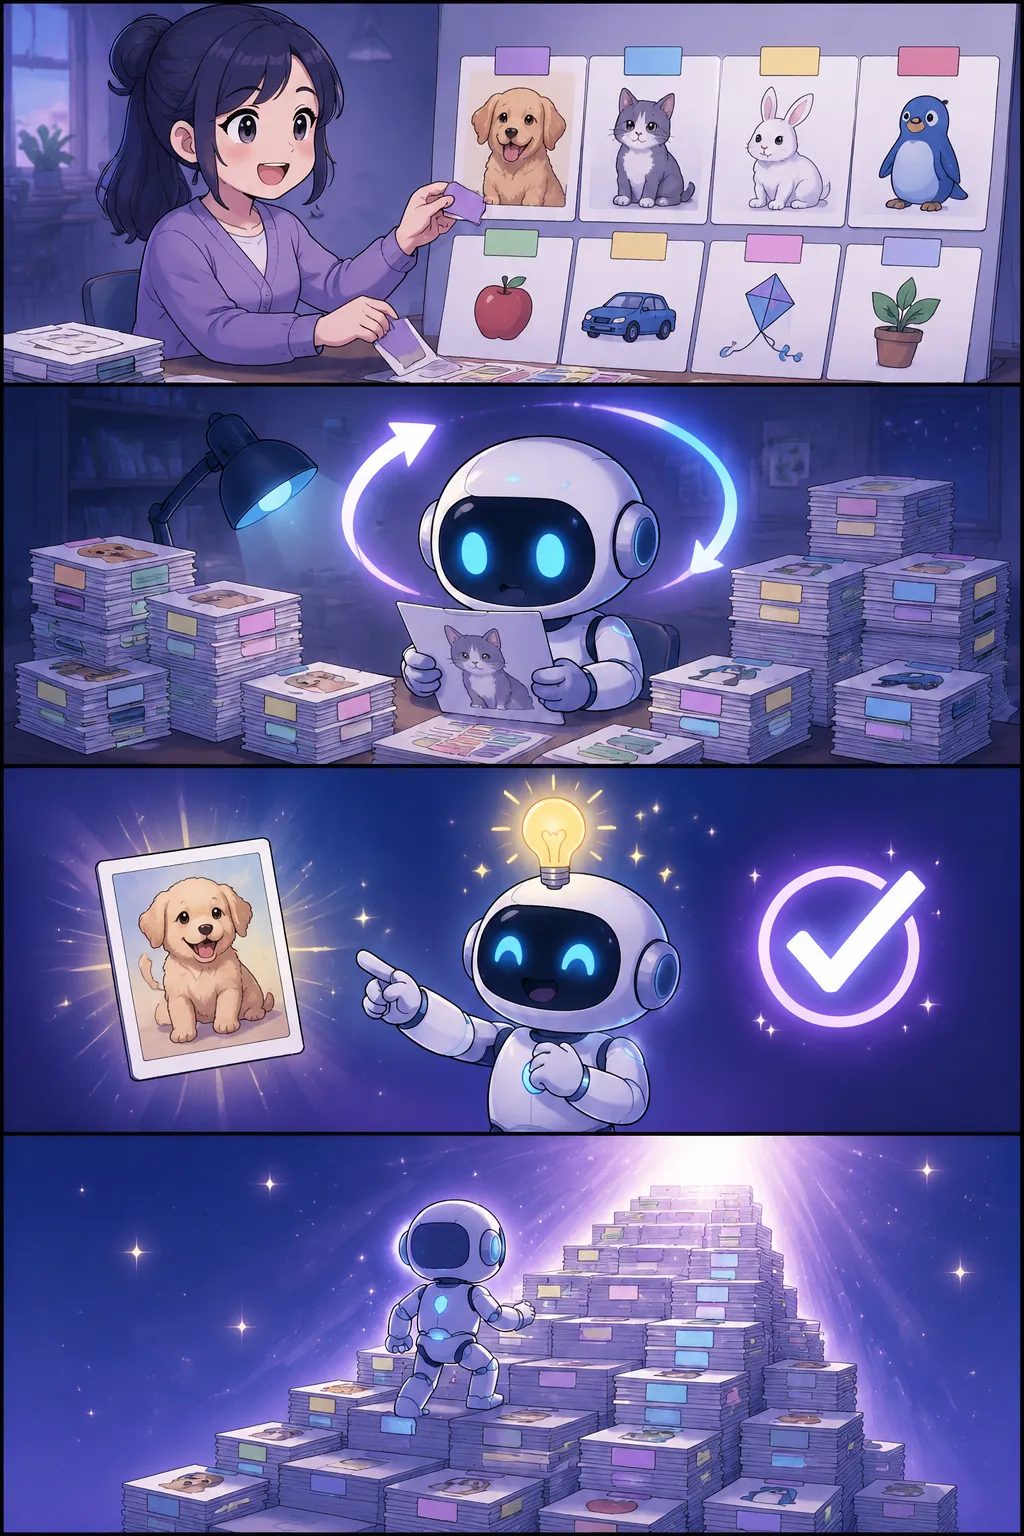
- 1선생님이 '이건 고양이야!' 라벨을 붙여줘요
- 2AI가 수천 장의 정답 사진을 반복 학습해요
- 3새 사진을 보여주자 '고양이입니다!' 척척 맞혀요
- 4정답 데이터가 많을수록 AI는 더 똑똑해져요
정의와 배경
지도학습(Supervised Learning)은 머신러닝의 세 가지 주요 학습 방식 중 하나로, 각 입력 데이터에 사람이 미리 정답(레이블 또는 라벨)을 부여한 학습 데이터를 사용해 모델을 훈련시키는 방법이다. '지도'라는 명칭은 정답을 알고 있는 교사(사람 또는 전문가)가 모델의 학습을 이끈다는 개념에서 유래한다. 이와 대비되는 방식으로는 정답 없이 데이터의 패턴을 스스로 찾는 비지도학습, 그리고 보상 신호를 통해 행동을 최적화하는 강화학습이 있다.
작동 원리와 주요 유형
지도학습 모델은 입력값(X)과 정답값(Y)의 쌍으로 구성된 학습 데이터를 반복 학습하면서, 입력에서 정답을 도출하는 함수를 내부적으로 형성한다. 학습이 완료된 모델은 정답을 모르는 새로운 입력에 대해서도 이 함수를 적용해 예측값을 산출한다.
주요 유형은 크게 두 가지다. 첫째, '분류(Classification)'는 입력 데이터를 미리 정해진 범주로 구분하는 작업으로, 이메일 스팸 판별·이미지 내 객체 인식·질환 진단 보조 등이 대표 사례다. 둘째, '회귀(Regression)'는 연속적인 수치를 예측하는 작업으로, 부동산 가격 예측이나 수요 예측 등이 해당된다.
공공·산업 분야에서의 중요성
지도학습은 현재 상용화된 AI 서비스의 상당 부분을 뒷받침하는 핵심 기술로, 공공 행정·의료·금융·제조 등 다양한 분야에 실제 적용되고 있다. 정부 민원 자동 분류, 세금 탈루 패턴 탐지, 의료 영상 판독 보조, 신용 위험 평가 등이 모두 지도학습 기반 시스템의 사례다.
다만 지도학습의 성능은 학습 데이터의 양과 품질에 크게 의존하기 때문에, 정확하고 편향 없는 레이블링 작업이 선행되어야 한다. 공공 부문에서 AI를 도입할 때는 학습 데이터의 대표성과 공정성을 확보하는 것이 중요한 정책적 과제로 꼽힌다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.