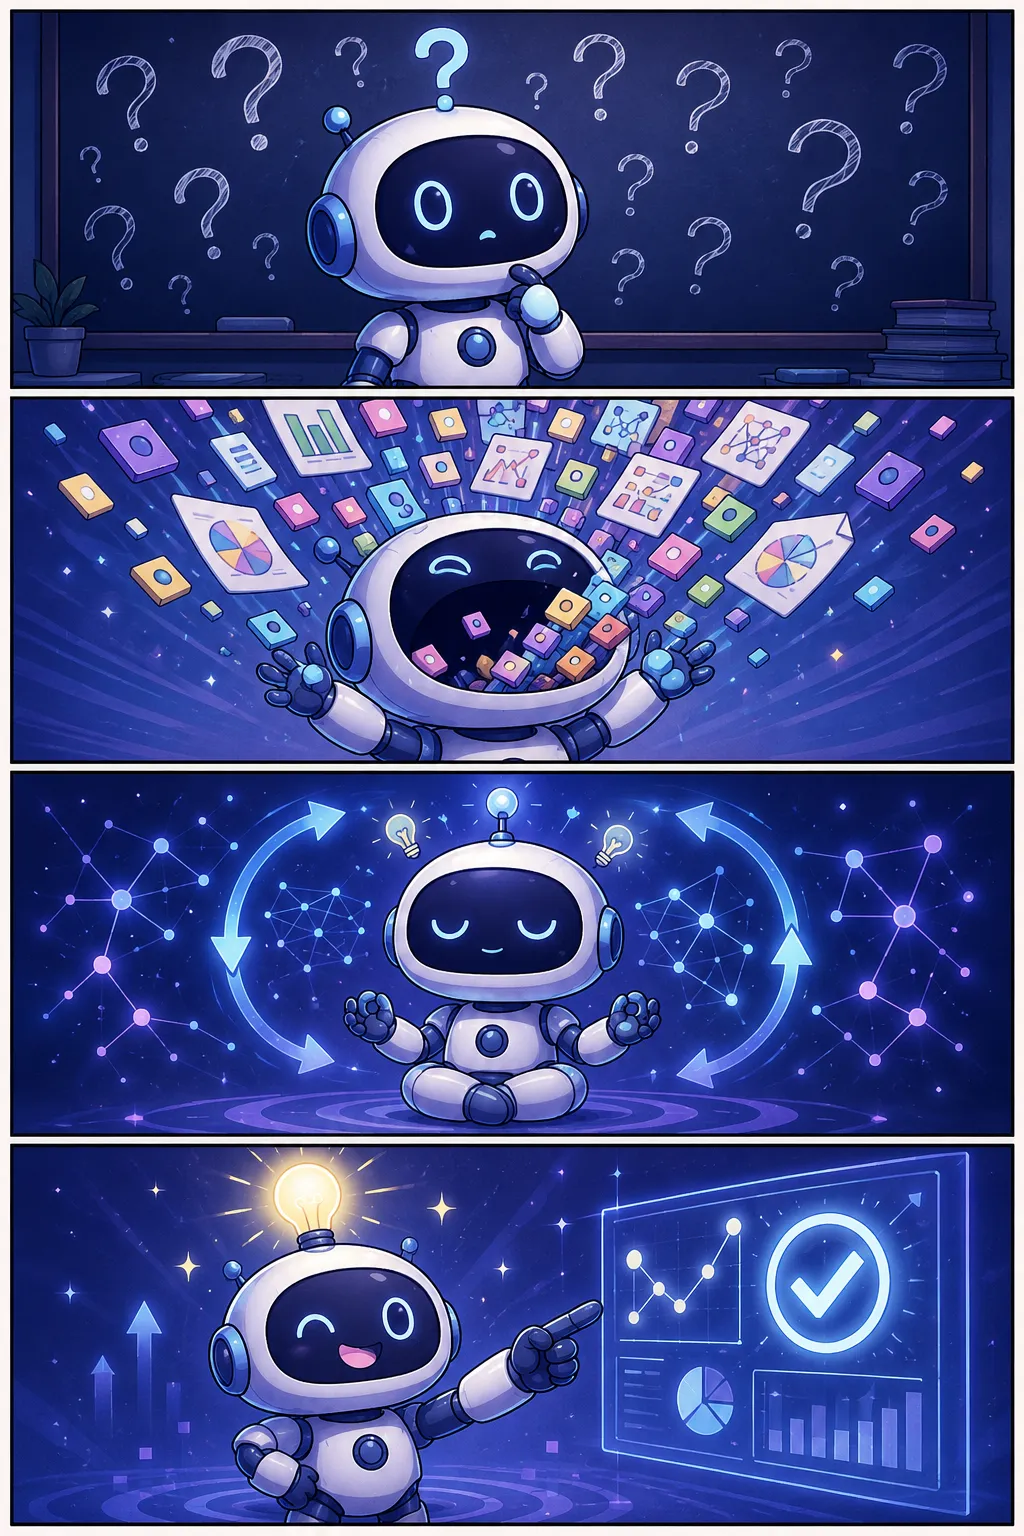
- 11컷: 규칙을 몰라 멍한 로봇
- 22컷: 데이터를 잔뜩 먹기 시작!
- 33컷: 반복할수록 똑똑해지는 중
- 44컷: 스스로 답을 찾아낸 로봇
정의와 배경
머신러닝은 학습 방식에 따라 크게 지도학습·비지도학습·강화학습으로 구분된다. 비지도학습(Unsupervised Learning)은 이 중 정답(레이블)이 부여되지 않은 데이터를 입력으로 받아, 모델이 자체적으로 데이터 내 숨겨진 구조나 패턴을 발견하는 학습 방법이다. 예컨대 수천 장의 고객 구매 기록에 '우수고객', '이탈고객'과 같은 분류를 붙이지 않아도, 모델이 유사한 행동 패턴을 가진 집단을 스스로 묶어 낼 수 있다. 레이블 작업에 드는 비용과 시간을 절감할 수 있어, 데이터 양이 폭발적으로 증가하는 현대 AI 환경에서 활용 범위가 넓어지고 있다.
주요 기법과 종류
비지도학습의 대표적 기법으로는 군집화(Clustering), 차원 축소(Dimensionality Reduction), 생성 모델(Generative Model)이 있다. 군집화는 K-평균(K-Means) 등의 알고리즘으로 데이터를 유사한 그룹으로 나누는 방법이며, 고객 세분화·이상 탐지 등에 활용된다. 차원 축소는 PCA(주성분 분석)나 오토인코더(Autoencoder)처럼 고차원 데이터를 핵심 특징만 남겨 압축하는 기법으로, 데이터 시각화나 전처리 단계에서 널리 쓰인다. 생성 모델 계열인 GAN(생성적 적대 신경망)이나 VAE(변분 오토인코더)도 비지도학습의 일환으로, 새로운 데이터를 스스로 생성하는 능력을 갖는다.
지도학습과의 비교 및 한계
지도학습은 명확한 정답이 있어 모델 성능을 측정하기 쉬운 반면, 비지도학습은 '무엇이 올바른 결과인가'를 정의하기 어렵다는 근본적 한계가 있다. 군집화 결과가 실제 비즈니스 의미와 일치하는지 여부는 도메인 전문가의 해석이 필요하며, 평가 지표 설계도 상대적으로 복잡하다. 이러한 이유로 실무에서는 소량의 레이블 데이터를 함께 활용하는 준지도학습(Semi-supervised Learning)이나, 사전학습 후 파인튜닝하는 방식과 결합해 사용되는 경우가 많다.
정책·산업적 중요성
정부 및 공공기관이 보유한 대량의 비정형 데이터(민원 텍스트, 의료 영상, 교통 로그 등)는 레이블 부여가 현실적으로 어렵기 때문에, 비지도학습은 공공 데이터 활용 전략의 핵심 수단 중 하나다. 또한 사이버 보안 분야에서 정상 패턴을 학습한 뒤 이상 행위를 탐지하거나, 행정 서비스 이용 패턴을 분석해 정책 수요를 예측하는 데에도 응용된다. AI 대전환 시대에 데이터 확보 경쟁이 심화될수록, 레이블 없이도 가치를 추출할 수 있는 비지도학습의 중요성은 더욱 높아질 것으로 전망된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.