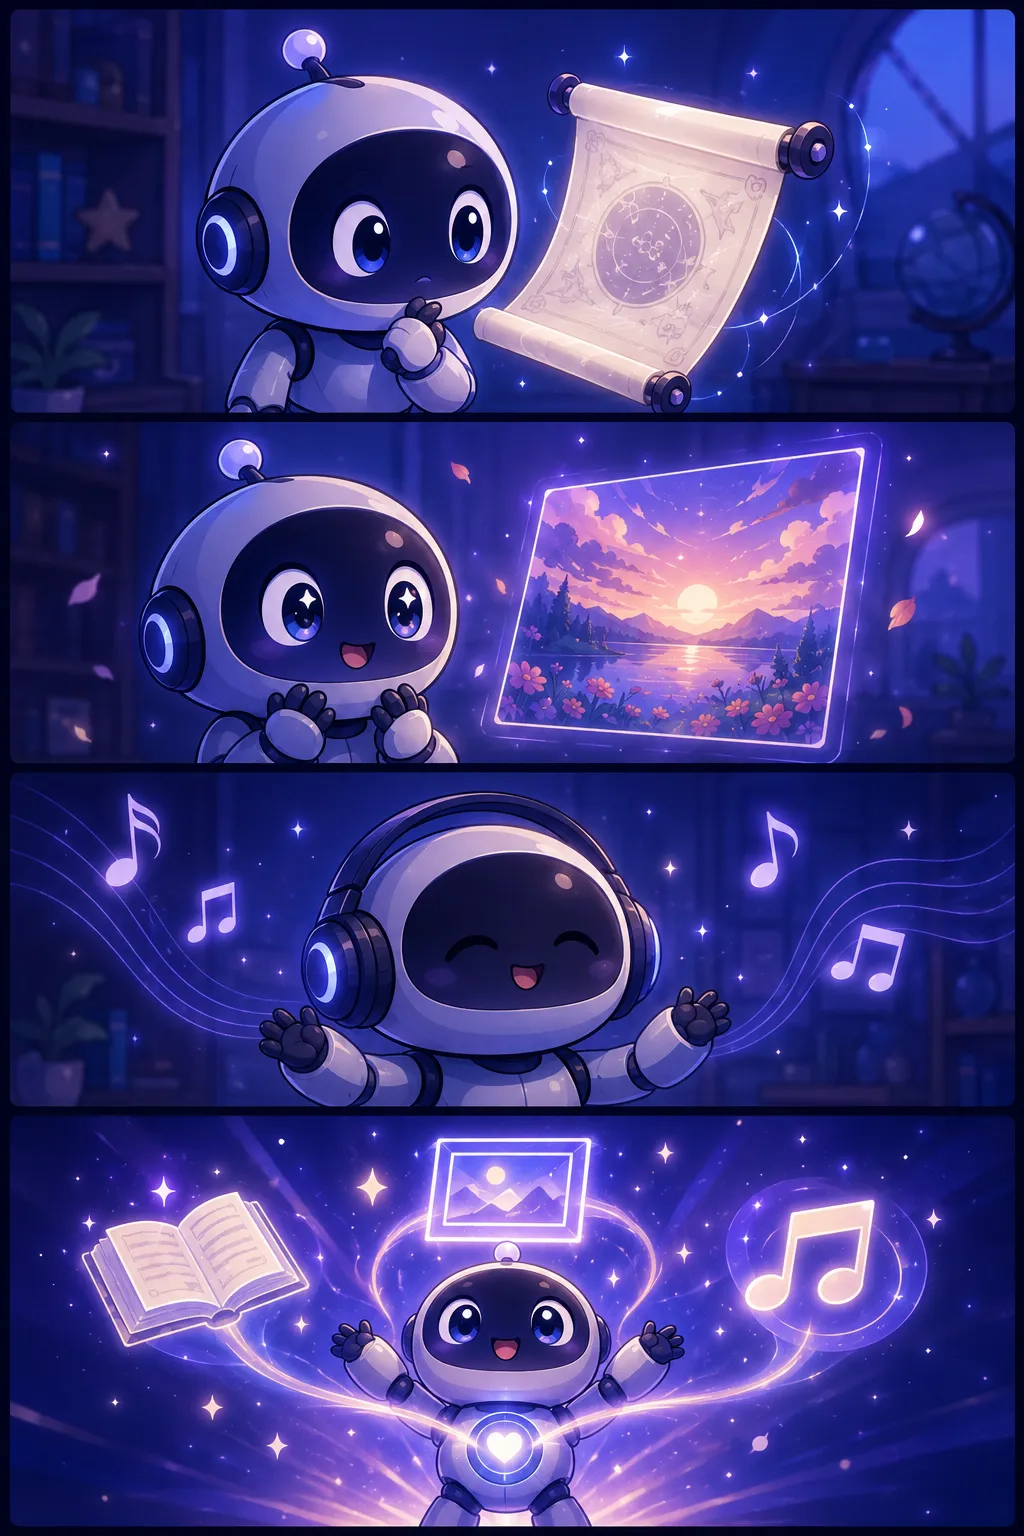
- 11컷: 로봇이 글자를 읽으며 '음…'
- 22컷: 로봇이 그림을 보며 '오!'
- 33컷: 로봇이 음악을 들으며 '흠흥~'
- 44컷: 모든 감각을 합쳐 '다 알아요!' 만능 로봇 완성!
정의와 배경
크로스모달은 '교차(cross)'와 '양식·모달리티(modal)'의 합성어로, 둘 이상의 이질적인 데이터 형식 사이에서 정보를 연결·변환·추론하는 방식을 가리킨다. 멀티모달 AI가 여러 양식을 함께 입력받아 처리하는 광의의 개념이라면, 크로스모달은 특히 '한 양식에서 다른 양식으로의 대응 또는 전이'에 초점을 맞춘 협의·파생 개념이다.
예를 들어 이미지를 보고 텍스트 설명을 생성하거나, 텍스트 문장으로부터 이미지를 검색·생성하거나, 음성 신호로부터 해당 장면을 추론하는 작업이 모두 크로스모달 처리에 해당한다. 이 개념은 인간이 청각·시각·언어 정보를 통합하여 의미를 이해하는 방식에서 착안하였다.
작동 원리와 주요 유형
크로스모달 학습의 핵심은 서로 다른 양식을 하나의 공통 표현 공간(공유 임베딩 공간)에 매핑하는 것이다. 이를 통해 텍스트 벡터와 이미지 벡터가 의미적으로 가까운 위치에 놓이게 되어, 한 양식으로 질의하면 다른 양식에서 연관 결과를 검색하거나 생성할 수 있다.
주요 유형으로는 ▲크로스모달 검색(예: 텍스트로 이미지 검색), ▲크로스모달 생성(예: 텍스트 설명으로 이미지·영상 생성), ▲크로스모달 추론(예: 이미지와 텍스트 질문을 결합해 답변 도출), ▲크로스모달 번역(예: 음성을 텍스트·수어로 변환) 등이 있다. 대조 학습(Contrastive Learning) 기법이 크로스모달 표현 학습에 널리 활용된다.
멀티모달 AI와의 관계 및 실무적 의의
멀티모달 AI는 여러 양식을 '함께 다루는' 시스템 전체를 지칭하며, 크로스모달은 그 내부에서 '양식 간 연결'을 담당하는 원리이자 세부 기술군이다. 즉, 크로스모달 능력이 뛰어날수록 멀티모달 AI의 이해·생성 품질이 높아진다.
공공·산업 실무 관점에서 크로스모달 기술은 민원 문서와 관련 이미지를 함께 분석하는 행정 AI, 의료 영상과 진료 기록을 연계하는 헬스케어 AI, 제조 현장의 센서 신호와 매뉴얼 텍스트를 결합하는 산업 AI 등 다양한 응용으로 이어진다. 따라서 AI 도입 정책 수립 시 단순 텍스트 처리 수준을 넘어 크로스모달 역량을 평가 기준에 포함하는 것이 중요하다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.