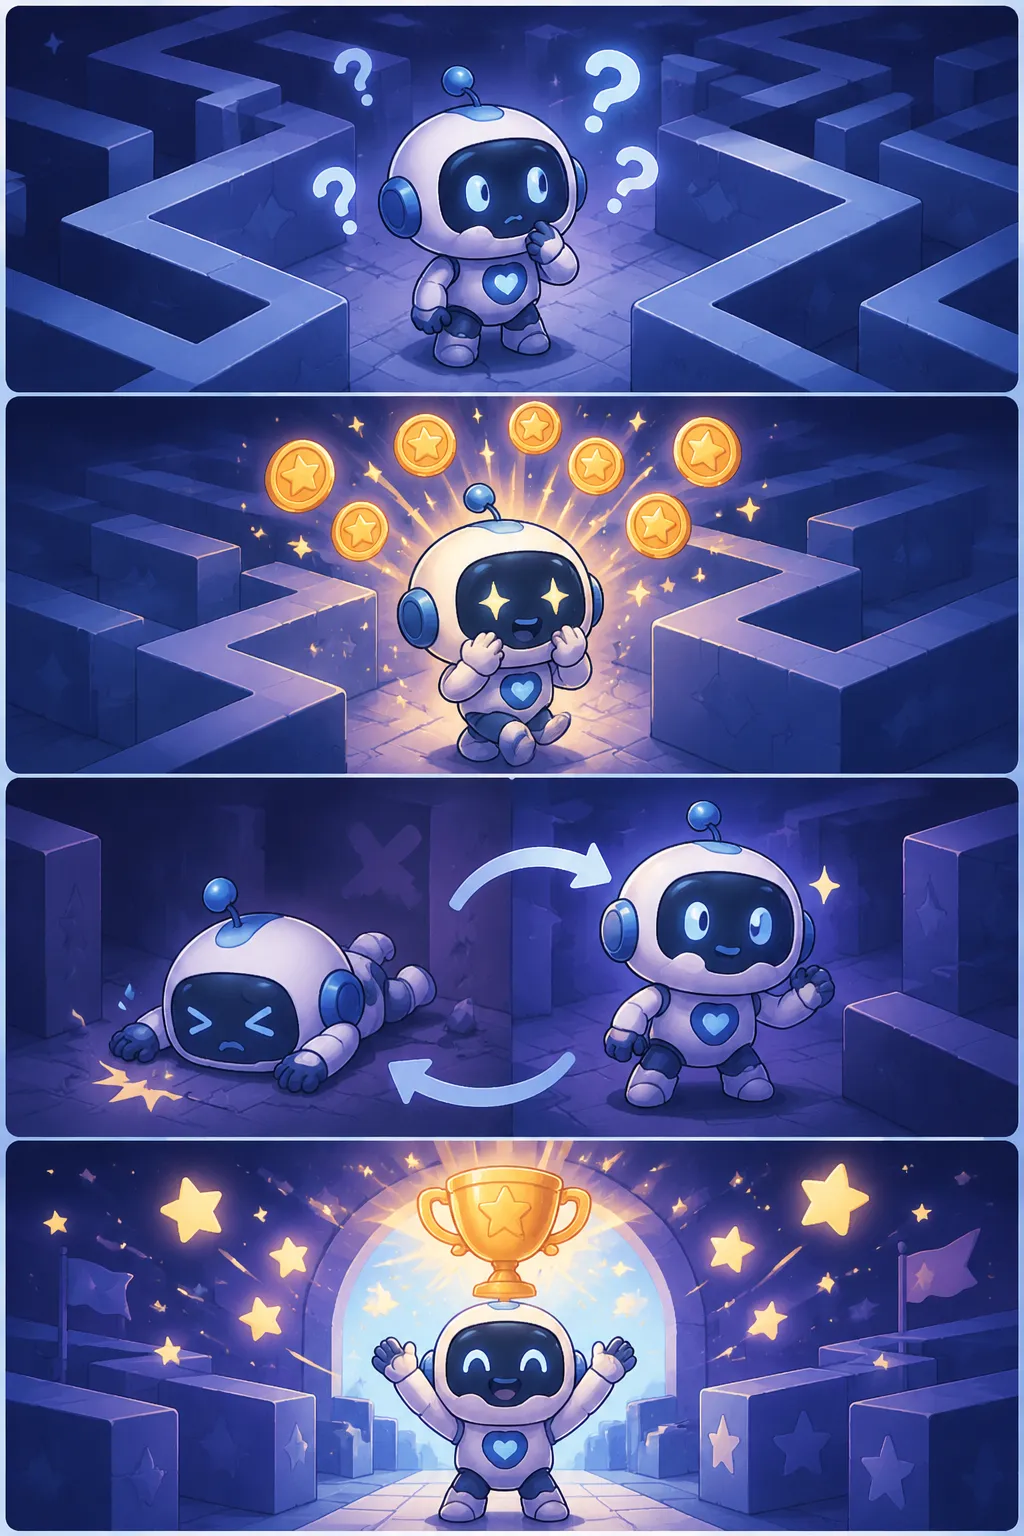
- 1로봇, 처음엔 아무것도 몰라요
- 2행동할 때마다 점수가 쌓여요!
- 3실패해도 괜찮아, 다시 도전!
- 4드디어 최고의 방법을 찾았다!
정의와 배경
강화학습에서 에이전트는 환경과 상호작용하며 누적 보상을 최대화하는 행동 전략, 즉 정책을 학습한다. 전통적인 가치 기반(value-based) 방법은 각 상태나 행동의 가치를 추정한 뒤 간접적으로 정책을 도출하지만, 정책 경사 방법은 정책 자체를 신경망 등으로 파라미터화하고 그 파라미터를 직접 최적화한다. 이 접근법은 연속적인 행동 공간이나 확률적 정책이 필요한 문제처럼 가치 함수 방식이 적용하기 어려운 환경에서 특히 유용하다.
작동 원리와 주요 알고리즘
핵심 아이디어는 정책 파라미터 θ에 대해 기대 누적 보상 J(θ)의 기울기 ∇J(θ)를 추정하고, 이를 이용해 파라미터를 경사 상승(gradient ascent) 방식으로 갱신하는 것이다. 실제 환경에서 기울기를 정확히 계산하기 어렵기 때문에, 에이전트가 수집한 궤적(trajectory) 샘플로 기울기를 근사 추정하는 몬테카를로(Monte Carlo) 방식을 주로 사용한다.
대표적인 알고리즘으로는 REINFORCE, Actor-Critic, PPO(Proximal Policy Optimization), TRPO(Trust Region Policy Optimization) 등이 있다. Actor-Critic 계열은 정책(Actor)과 가치 함수(Critic)를 함께 학습하여 기울기 추정의 분산을 줄이고 학습 안정성을 높인다. PPO는 정책 갱신 폭을 제한해 학습 붕괴를 방지하는 방식으로, 현재 실무에서 가장 널리 쓰이는 알고리즘 중 하나다.
왜 중요한가
정책 경사 방법은 대규모 언어 모델(LLM)의 인간 피드백 기반 강화학습(RLHF)에 핵심 기술로 채택되어 있어, 현재 생성형 AI 정렬(alignment) 연구의 실용적 토대가 된다. 로봇공학, 자율주행, 게임 AI처럼 연속적이고 고차원적인 행동 공간이 필요한 산업 분야에서도 필수적인 알고리즘으로 자리잡았다. 정책 실무자 관점에서는, AI 시스템이 단순히 패턴을 인식하는 것을 넘어 목표 지향적으로 의사결정을 학습하는 원리를 이해하는 데 있어 정책 경사 개념이 중요한 참조점이 된다.
한계와 고려사항
정책 경사 방법의 주요 한계는 기울기 추정의 높은 분산(variance)으로 인해 학습이 불안정하거나 수렴 속도가 느릴 수 있다는 점이다. 또한 샘플 효율성이 낮아 충분한 학습을 위해 많은 환경 상호작용 데이터가 필요하다는 점도 실제 적용 시 비용 부담이 된다. 이러한 한계를 완화하기 위해 기준선(baseline) 설정, 중요도 샘플링(importance sampling), 클리핑(clipping) 등 다양한 분산 감소 기법이 함께 사용된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.