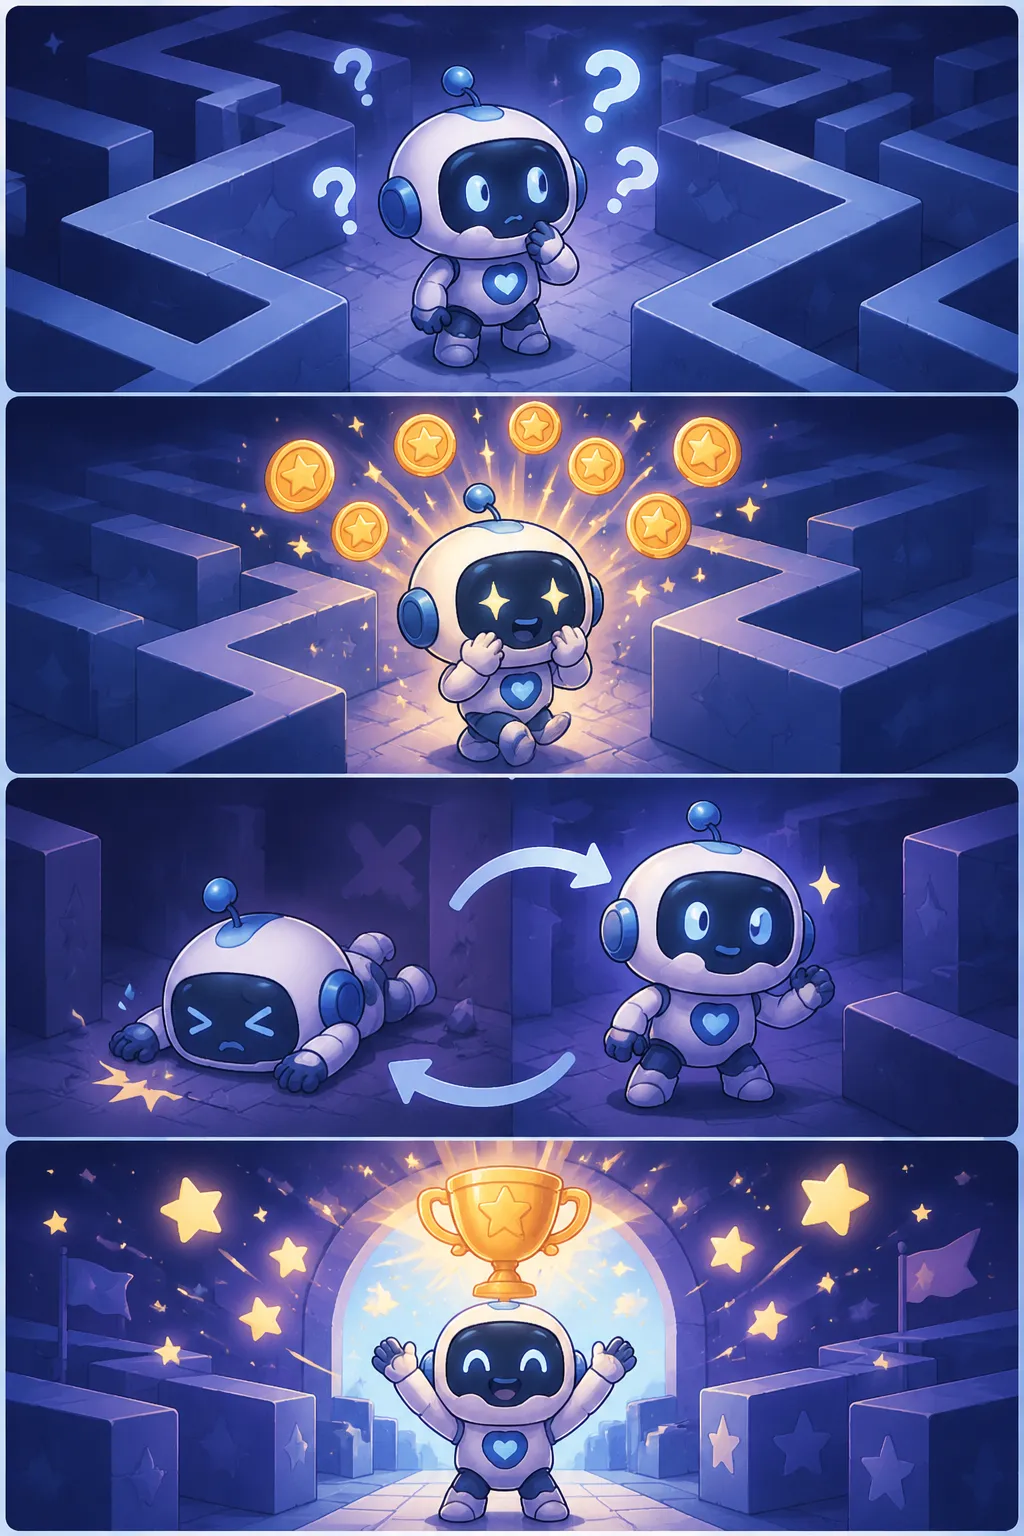
- 1로봇, 처음엔 아무것도 몰라요
- 2행동할 때마다 점수가 쌓여요!
- 3실패해도 괜찮아, 다시 도전!
- 4드디어 최고의 방법을 찾았다!
정의와 배경
Q-러닝은 1989년 크리스 워트킨스(Chris Watkins)가 제안한 강화학습 알고리즘으로, 에이전트가 시행착오를 통해 최적 행동 전략을 스스로 학습하는 방법이다. 여기서 'Q'는 특정 상태(state)에서 특정 행동(action)을 취했을 때 얻을 수 있는 기대 누적 보상의 품질(Quality)을 의미한다. 에이전트는 환경으로부터 받은 보상 신호를 바탕으로 Q값 테이블을 반복 갱신하며, 최종적으로 각 상황에서 Q값이 가장 높은 행동을 선택하는 최적 정책에 수렴한다.
작동 원리와 종류
Q-러닝의 핵심은 벨만 방정식(Bellman Equation)에 기반한 Q값 갱신 규칙이다. 에이전트는 현재 상태에서 행동을 취한 뒤 보상과 다음 상태를 관찰하고, 이를 이용해 Q값을 점진적으로 수정한다. 상태·행동 공간이 단순할 경우 Q값을 2차원 테이블로 표현하지만, 상태 공간이 방대하거나 연속적일 경우 신경망으로 Q함수를 근사하는 심층 Q-네트워크(Deep Q-Network, DQN)를 사용한다. DQN은 경험 재현(experience replay)과 목표 네트워크(target network) 기법을 도입해 학습 안정성을 높인 것이 특징이다.
강화학습 내 위상과 한계
Q-러닝은 환경의 내부 구조를 알지 못해도 적용 가능한 모델-프리 방식이라는 점에서 실용성이 높으며, 강화학습 이론과 실습의 출발점으로 널리 활용된다. 다만 상태·행동 공간이 매우 크거나 연속적인 제어 문제에서는 수렴 속도가 느리거나 불안정할 수 있다. 이를 보완하기 위해 정책 경사법(Policy Gradient), 액터-크리틱(Actor-Critic) 등 다양한 파생 알고리즘이 개발되었으며, Q-러닝은 이러한 현대 강화학습 방법론의 이론적 토대로 자리잡고 있다.
왜 중요한가
Q-러닝과 그 확장인 DQN은 게임, 로봇 제어, 자율주행, 추천 시스템 등 다양한 분야에서 실질적 성과를 보여주며 AI 산업 응용의 범위를 크게 넓혔다. 정책·산업 실무 관점에서는 Q-러닝 기반 강화학습이 최적 자원 배분, 물류 경로 최적화, 에너지 관리 등 복잡한 의사결정 자동화에 활용될 수 있다는 점에서 주목할 필요가 있다. AI 대전환 시대에 강화학습 기반 시스템의 도입 타당성을 검토할 때 Q-러닝의 원리를 이해하는 것은 기술 선택과 평가의 기초가 된다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.