PPO
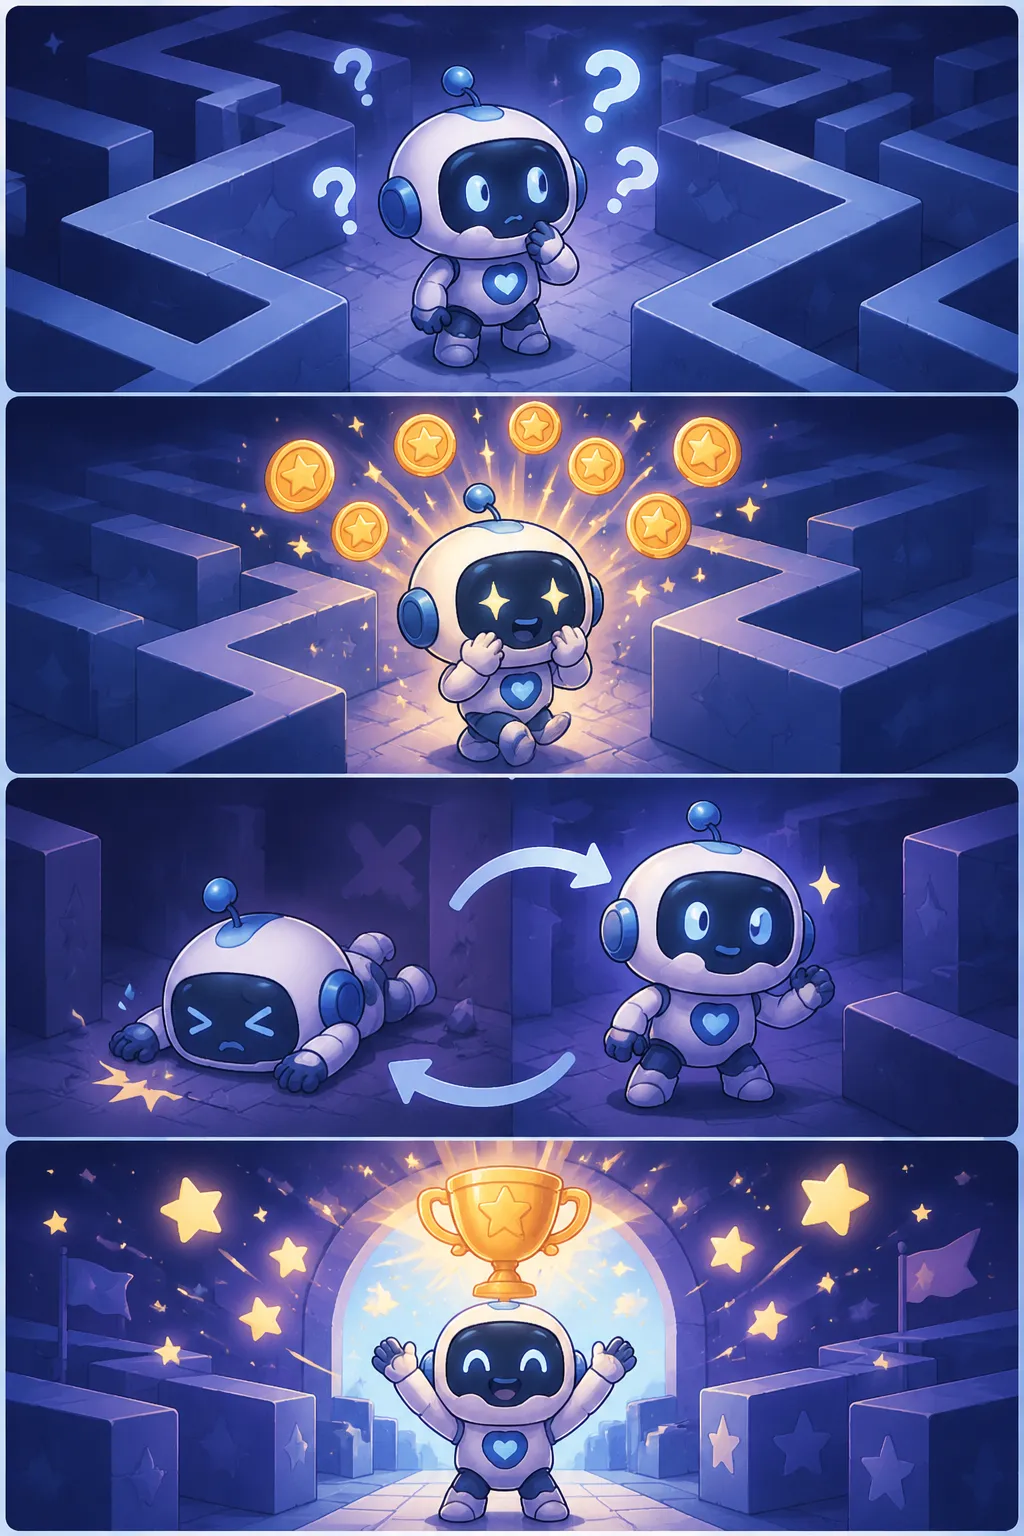
- 1로봇, 처음엔 아무것도 몰라요
- 2행동할 때마다 점수가 쌓여요!
- 3실패해도 괜찮아, 다시 도전!
- 4드디어 최고의 방법을 찾았다!
정의와 배경
PPO는 강화학습의 핵심 과제인 '정책 업데이트를 얼마나 크게 할 것인가'의 문제를 해결하기 위해 OpenAI 연구진이 제안한 알고리즘이다. 강화학습에서 에이전트는 환경과 상호작용하며 누적 보상을 최대화하는 방향으로 행동 정책을 점진적으로 수정하는데, 한 번에 정책을 너무 크게 바꾸면 학습이 발산하거나 성능이 급격히 저하되는 문제가 있다. PPO는 이전 정책과 새 정책 사이의 변화 폭을 일정 범위(클립·clip) 내로 제한하는 방식으로 이 문제를 완화한다. 이러한 접근은 이전에 제안된 TRPO(Trust Region Policy Optimization)의 수학적 엄밀성을 유지하면서도 계산 복잡도를 낮춘 실용적 대안으로 평가받는다.
작동 원리와 주요 특징
PPO의 핵심 아이디어는 '클리핑된 대리 목적함수(Clipped Surrogate Objective)'로, 새 정책이 구 정책에 비해 특정 비율 이상 벗어나지 않도록 목적함수 자체에 제약을 내장하는 방식이다. 이를 통해 별도의 복잡한 제약 조건 최적화 없이도 안정적인 정책 업데이트가 가능하다.
실제 구현에서는 수집된 경험 데이터를 여러 미니배치로 나누어 반복 학습하는 '다중 에포크 업데이트' 방식을 사용하므로, 데이터 활용 효율이 높다는 장점이 있다. 또한 Actor-Critic 구조를 기반으로 하여 가치 함수(Value Function)와 정책 함수(Policy Function)를 동시에 학습한다.
AI 언어모델 정렬(Alignment)에서의 역할
PPO는 최근 ChatGPT·GPT-4 등 대형 언어모델(LLM)의 인간 선호 정렬(RLHF, Reinforcement Learning from Human Feedback) 과정에서 핵심 알고리즘으로 활용되어 주목받고 있다. RLHF에서는 인간 평가자의 피드백으로 구축한 보상 모델(Reward Model)을 기반으로 언어모델이 더 유용하고 안전한 응답을 생성하도록 PPO를 통해 미세조정(Fine-tuning)한다. 이 과정에서 PPO의 안정적인 정책 업데이트 특성이 모델 성능 붕괴를 방지하는 데 중요한 역할을 한다. 다만 RLHF+PPO 파이프라인은 구현 복잡도가 높고 보상 모델의 품질에 크게 의존한다는 한계도 지적된다.
정책·산업적 시사점
정부 및 공공 AI 서비스 도입 시, PPO 기반 RLHF 정렬 기술은 AI 모델이 편향된 응답이나 유해 콘텐츠를 줄이고 공익적 목적에 부합하는 결과를 산출하도록 조정하는 핵심 수단이다. 따라서 공공 AI 시스템의 신뢰성·안전성 확보 요건을 검토할 때 해당 모델이 어떤 정렬 기법을 적용했는지, PPO 등 강화학습 기반 정렬 과정이 포함되었는지를 조달·평가 기준에 반영할 필요가 있다. 또한 PPO 학습에는 상당한 컴퓨팅 자원이 요구되므로, 국내 AI 기업의 고성능 인프라 수요와도 직결되는 기술 요소로 이해할 수 있다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.