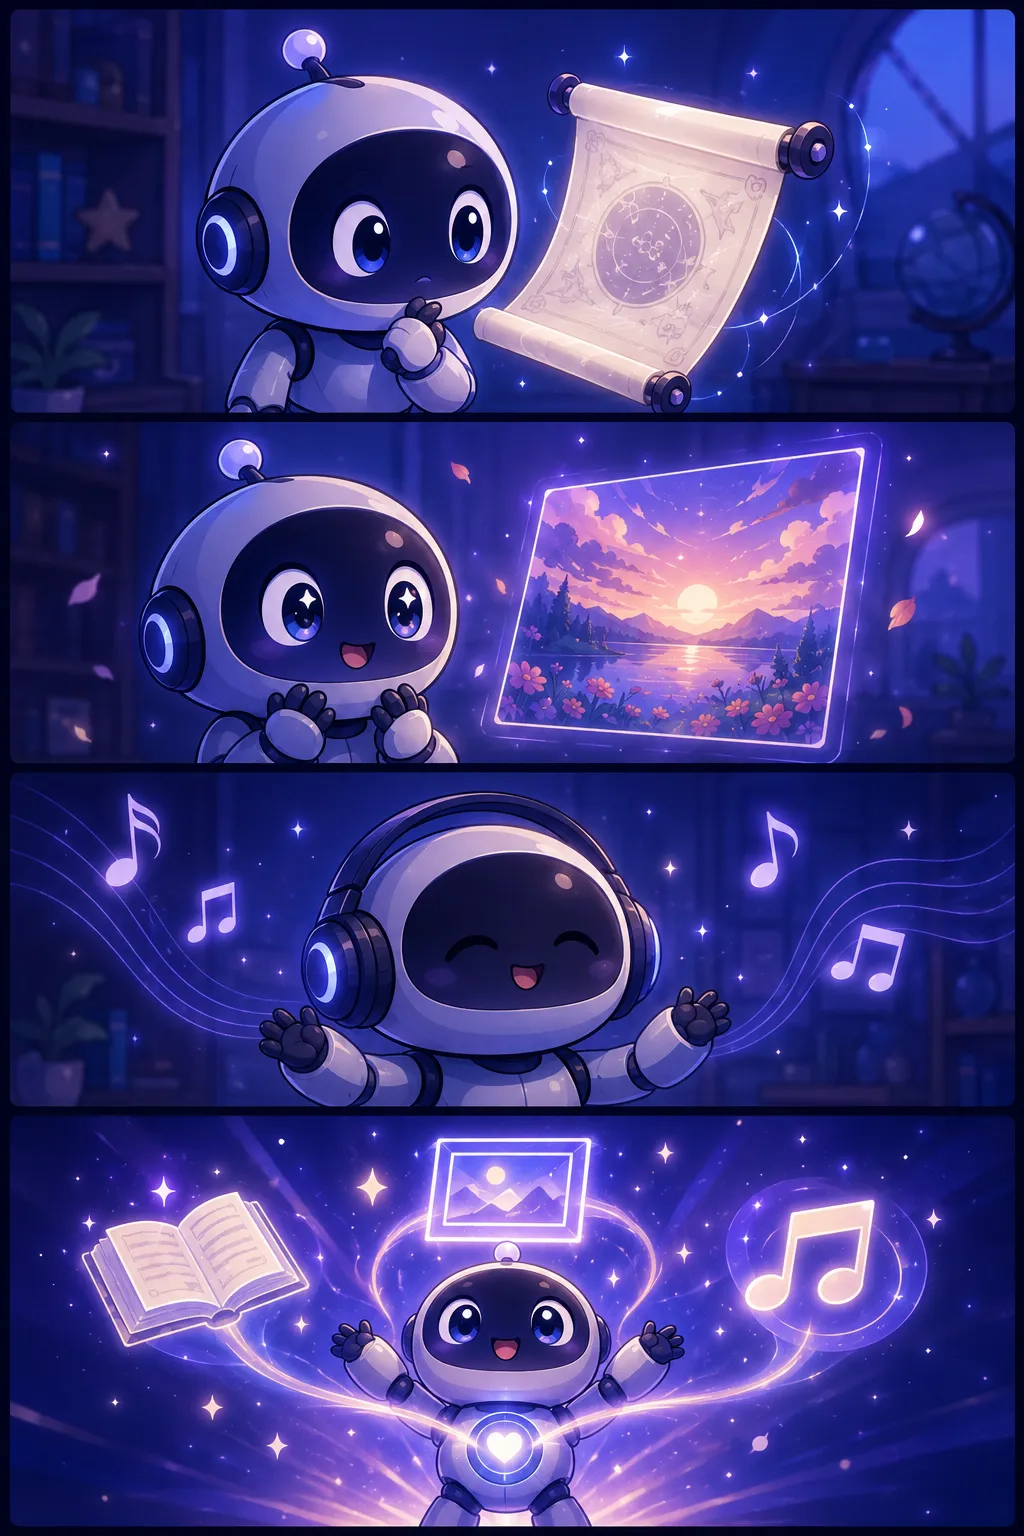
- 11컷: 로봇이 글자를 읽으며 '음…'
- 22컷: 로봇이 그림을 보며 '오!'
- 33컷: 로봇이 음악을 들으며 '흠흥~'
- 44컷: 모든 감각을 합쳐 '다 알아요!' 만능 로봇 완성!
정의와 배경
텍스트-이미지 모델이란 '고양이가 우주복을 입고 있는 모습'과 같은 자연어 프롬프트(지시문)를 입력받아, 그 내용을 시각적으로 표현한 이미지를 자동으로 생성하는 AI 모델을 말한다. 이는 텍스트와 이미지라는 서로 다른 두 가지 데이터 형식을 동시에 다루는 멀티모달 AI의 핵심 응용 분야 중 하나다.
초기에는 단순한 이미지 분류·인식 수준에 머물던 AI 기술이 딥러닝과 대규모 학습 데이터의 발전을 토대로 생성(Generation) 단계로 진화하면서, 텍스트-이미지 모델이 본격적으로 등장하였다. 방대한 양의 텍스트-이미지 쌍 데이터를 학습한 결과, 모델은 언어적 개념과 시각적 표현 사이의 복잡한 대응 관계를 습득하게 된다.
작동 원리와 주요 방식
텍스트-이미지 모델의 핵심은 텍스트 인코더와 이미지 생성기의 결합이다. 텍스트 인코더는 입력된 자연어 문장을 수치 벡터(임베딩)로 변환하고, 이미지 생성기는 이 벡터를 조건 신호로 삼아 픽셀 또는 잠재 공간(latent space)에서 이미지를 합성한다.
현재 가장 널리 쓰이는 방식은 확산 모델(Diffusion Model)로, 무작위 노이즈에서 출발해 텍스트 조건에 맞춰 점진적으로 노이즈를 제거하며 이미지를 완성하는 방식이다. 이 외에도 생성적 적대 신경망(GAN) 기반 방식과 자기회귀(Autoregressive) 방식이 사용되어 왔으며, 최근에는 확산 모델이 생성 품질 면에서 두드러진 성과를 보이고 있다. 파인튜닝을 통해 특정 화풍, 산업 분야, 기관 특성에 맞게 모델을 추가 조정하는 것도 가능하다.
왜 중요한가
텍스트-이미지 모델은 전문적인 디자인 소프트웨어 역량 없이도 고품질 시각 콘텐츠를 빠르게 생성할 수 있어, 콘텐츠 제작 비용과 시간을 크게 단축시킨다. 공공 부문에서는 정책 홍보물, 교육 자료, 재난 안내 이미지 등 다양한 시각 커뮤니케이션에 활용될 수 있다.
반면, 허위 정보 유포, 초상권·저작권 침해, 딥페이크 악용 등 윤리적·법적 리스크도 함께 부각되고 있어 활용 가이드라인 마련이 중요한 과제로 떠오르고 있다. 정책·산업 실무자 입장에서는 생성 이미지의 출처 표시, 인공지능 생성물 표기 의무 등 관련 제도 동향을 함께 파악할 필요가 있다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.