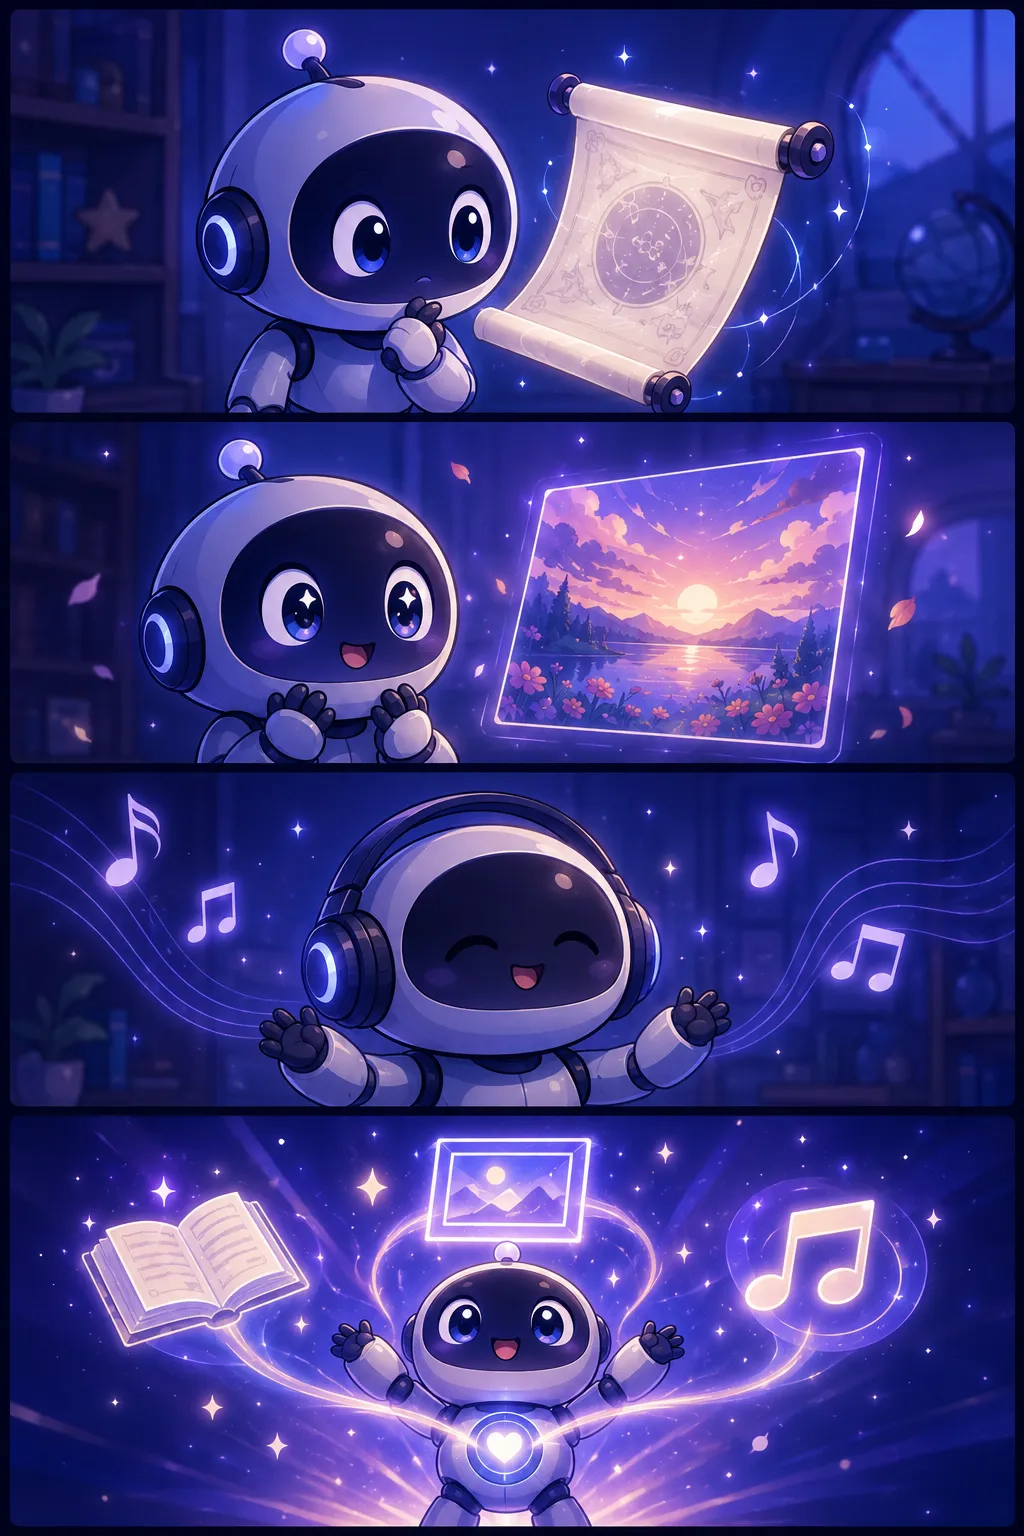
- 11컷: 로봇이 글자를 읽으며 '음…'
- 22컷: 로봇이 그림을 보며 '오!'
- 33컷: 로봇이 음악을 들으며 '흠흥~'
- 44컷: 모든 감각을 합쳐 '다 알아요!' 만능 로봇 완성!
정의와 배경
비전-언어 모델(Vision-Language Model, VLM)은 컴퓨터 비전(시각 처리)과 자연어 처리(언어 이해)를 하나의 통합 모델로 결합한 인공지능 기술이다. 전통적으로 이미지 인식과 언어 생성은 별개의 모델이 담당했으나, 대규모 사전학습 패러다임의 발전과 함께 두 영역을 단일 아키텍처에서 처리하는 방향으로 진화하였다. 멀티모달 AI의 대표적 파생 형태로, 텍스트만을 입력·출력으로 삼는 대규모 언어 모델(LLM)과 달리 시각 정보를 핵심 입력으로 수용한다는 점이 특징이다.
작동 원리와 주요 유형
VLM은 일반적으로 이미지를 수치 벡터로 변환하는 시각 인코더(예: 비전 트랜스포머)와, 언어를 처리하는 언어 모델을 결합하여 구성된다. 두 모듈은 공통된 임베딩 공간에서 시각 특징과 언어 특징을 정렬(alignment)하는 방식으로 훈련되며, 이를 통해 모델은 이미지와 텍스트 간의 의미적 관계를 학습한다.
주요 활용 유형으로는 이미지 캡셔닝(이미지에 대한 자연어 설명 생성), 시각적 질의응답(VQA), 이미지-텍스트 검색, 문서 이해(차트·표·수식 해석), 이미지 기반 대화 등이 있다. 최근에는 영상(동영상) 입력까지 처리 범위를 확장하는 모델도 등장하고 있다.
왜 중요한가
VLM은 실세계 정보의 상당 부분이 이미지·도표·문서 등 시각 형태로 존재한다는 점에서 실용적 파급력이 크다. 의료 영상 판독 보조, 자율주행 환경 인식, 제조 현장 품질 검사, 행정 문서 자동 분류 등 다양한 공공·산업 분야에 적용 가능하다.
정책·행정 실무 관점에서도 VLM은 대량의 이미지 기반 민원 서류나 현장 사진을 자동으로 분석하는 데 활용될 수 있어, AI 행정 자동화의 핵심 기반 기술로 주목받고 있다. 다만 학습 데이터의 편향, 시각 정보 오해석(환각), 개인정보 보호 등의 과제는 도입 시 면밀히 검토해야 한다.
관련 개념과의 관계
VLM은 멀티모달 AI의 하위 유형으로, 처리 양식이 시각과 언어 두 가지로 한정된다는 점에서 음성·센서 등 더 넓은 모달리티를 아우르는 멀티모달 AI보다 좁은 개념이다. 파인튜닝 기법을 활용하면 범용 VLM을 특정 도메인(예: 의료 영상, 위성 이미지)에 맞게 추가 학습시켜 성능을 높일 수 있다. 딥러닝과 트랜스포머 아키텍처가 기술적 토대를 이루며, 대규모 이미지-텍스트 쌍으로 구성된 학습 데이터의 품질과 규모가 모델 성능에 직접적인 영향을 미친다.
※ 본 상세 설명은 용어집 데이터를 토대로 AI가 생성했습니다. 정확한 내용은 원문 출처를 우선하세요.